AI 환각(hallucination)은 생성형 AI가 사실이 아니거나 근거가 없는 내용을 사실처럼 자신 있게 말하는 현상입니다. 없는 논문이나 판례를 인용하고, 날짜와 숫자를 틀리고, 주어진 문서에 없는 내용을 요약에 끼워 넣는 일이 모두 여기에 해당합니다.
한눈에 보기
- AI 환각은 AI가 사실이 아니거나 근거 없는 내용을 자신 있게 말하는 현상이며, 최신 모델에서도 사라지지 않았습니다.
- AI는 사실을 찾아보는 대신 그럴듯한 다음 말을 고르고, 모를 때도 답하도록 길들여져 있어서 환각이 생깁니다.
- 출처를 요구하고, 원문을 직접 열어 숫자를 대조하고, 중요한 답은 사람이 확인하는 것이 지금 쓸 수 있는 방법입니다.
환각이 까다로운 이유는 틀린 답이 틀려 보이지 않는다는 데 있습니다. 문장은 매끄럽고 말투는 확신에 차 있습니다. 그래서 사람이 확인하지 않고 그대로 쓰면 소송 서류, 보고서, 고객 안내에 오류가 그대로 실립니다. 이 글은 환각이 왜 생기는지, 얼마나 자주 생기는지, 그리고 어떻게 줄이는지를 공개된 연구와 사건으로 정리합니다.
이런 상황을 떠올려 보세요
중소 제조업체의 마케터가 신제품 보도자료를 쓰고 있습니다. 첫 문단에 시장 규모를 한 줄 넣고 싶어 ChatGPT에 "국내 가정용 공기청정기 시장 규모를 알려 줘"라고 묻습니다. 답은 곧바로 나옵니다. "2024년 국내 시장 규모는 약 1조 2천억 원이며, 연평균 8.3% 성장하고 있습니다." 숫자가 구체적이고 말투도 단정해서 그대로 붙여 넣고 싶어집니다. (이 대화는 설명을 위해 만든 예시입니다.)
마케터는 보내기 전에 한 번 더 확인하기로 합니다.
- 출처를 묻습니다. "이 숫자의 출처를 보고서 이름과 링크로 알려 줘"라고 하자, AI는 어느 민간 연구소가 냈다는 "2024 국내 생활가전 시장 동향 보고서"를 댑니다.
- 원문을 직접 엽니다. 링크를 누르니 페이지가 없습니다. 보고서 제목으로 검색해도, 그 연구소 누리집의 자료실을 뒤져도 같은 이름의 보고서가 나오지 않습니다.
- 숫자를 대조합니다. 업계 협회와 통계 기관의 공개 자료를 찾아보니 시장 규모를 재는 기준부터 달라서, 1조 2천억 원이라는 숫자와 맞춰 볼 근거가 없습니다.
결국 마케터는 그 문장을 빼고, 원문을 확인한 공개 통계만 출처와 함께 넣었습니다. 만약 그대로 배포했다면 기자나 경쟁사가 출처를 물었을 때 회사가 답할 수 없었을 것입니다. AI가 보고서 이름까지 지어낸 이 장면이 바로 환각입니다.
환각의 정의와 두 갈래
자연어 생성 분야의 환각을 정리한 Ji 등의 서베이(survey, 한 분야의 연구를 모아 정리한 논문)는 2022년 초고가 공개되고 2023년 ACM Computing Surveys에 실렸습니다. 이 논문은 환각을 "말이 안 되거나, 주어진 원문에 충실하지 않은 생성 내용"으로 정의했습니다. 심리학에서 환각이 "실제가 아닌데 실제처럼 느껴지는 지각"이라는 데서 이름을 빌려 왔다고 설명합니다.
대규모 언어 모델(LLM)이 널리 쓰이면서 분류는 더 정교해졌습니다. 2023년 Huang 등의 서베이는 환각을 크게 둘로 나눕니다.
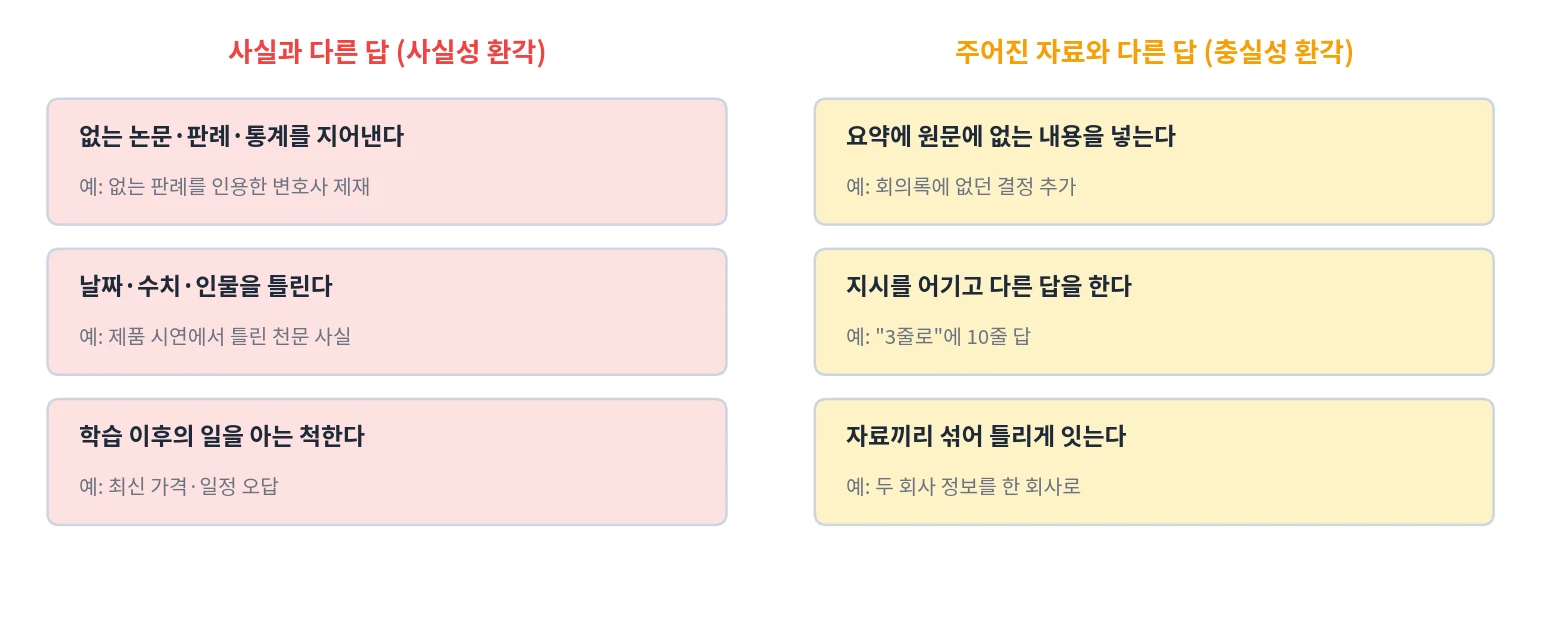
- 사실성 환각: 세상의 사실과 다른 답입니다. 사실을 틀리게 말하거나, 확인할 수 없는 사실을 지어냅니다.
- 충실성 환각: 사용자가 준 지시나 자료와 다른 답입니다. 요약에 원문에 없는 내용을 넣거나, 지시와 다른 형식으로 답하거나, 앞뒤 논리가 맞지 않습니다.
앞의 보도자료 장면은 사실성 환각입니다. 회의록을 요약해 달라고 했는데 회의에서 나오지 않은 결정 사항이 요약에 들어가 있다면, 그것은 충실성 환각입니다.
용어를 두고도 논의가 있습니다. 미국 국립표준기술연구소(NIST)는 2024년 생성형 AI 위험 지침(AI 600-1)에서 "환각" 대신 작화(confabulation)라는 말을 씁니다. 환각이라는 말이 AI에 사람의 지각을 덧씌운다는 지적 때문입니다. NIST는 이를 "생성형 AI가 잘못되거나 거짓인 내용을 만들어 자신 있게 내놓는 현상"으로 정의하고, 답을 정당화하려고 논리나 인용까지 지어낼 수 있다고 적었습니다.
왜 생기나
사실 대신 그럴듯한 다음 단어를 고르는 방식
NIST는 작화가 "생성형 모델이 설계된 방식의 자연스러운 결과"라고 설명합니다. 언어 모델은 학습 데이터의 통계적 분포를 흉내 내도록 만들어졌고, 문장에서 다음에 올 토큰(token, AI가 글을 읽고 쓰는 조각 단위로, 보통 단어 하나보다 조금 작은 단위)을 예측합니다. 질문에 답할 때도 데이터베이스에서 사실을 꺼내는 것이 아니라, 그 자리에 올 법한 단어를 확률로 고릅니다.
휴대폰 자판의 자동완성을 떠올리면 쉽습니다. "내일 회의는"까지 치면 자판이 "몇 시", "취소" 같은 다음 말을 띄워 줍니다. 자판은 내일 회의가 실제로 취소됐는지 모릅니다. 그동안 자주 이어 쓴 말을 내밀 뿐입니다. 언어 모델은 이 자동완성을 훨씬 크고 정교하게 만든 것이라서 문장은 자연스럽지만, 그 문장이 사실인지는 따로 확인하지 않습니다.
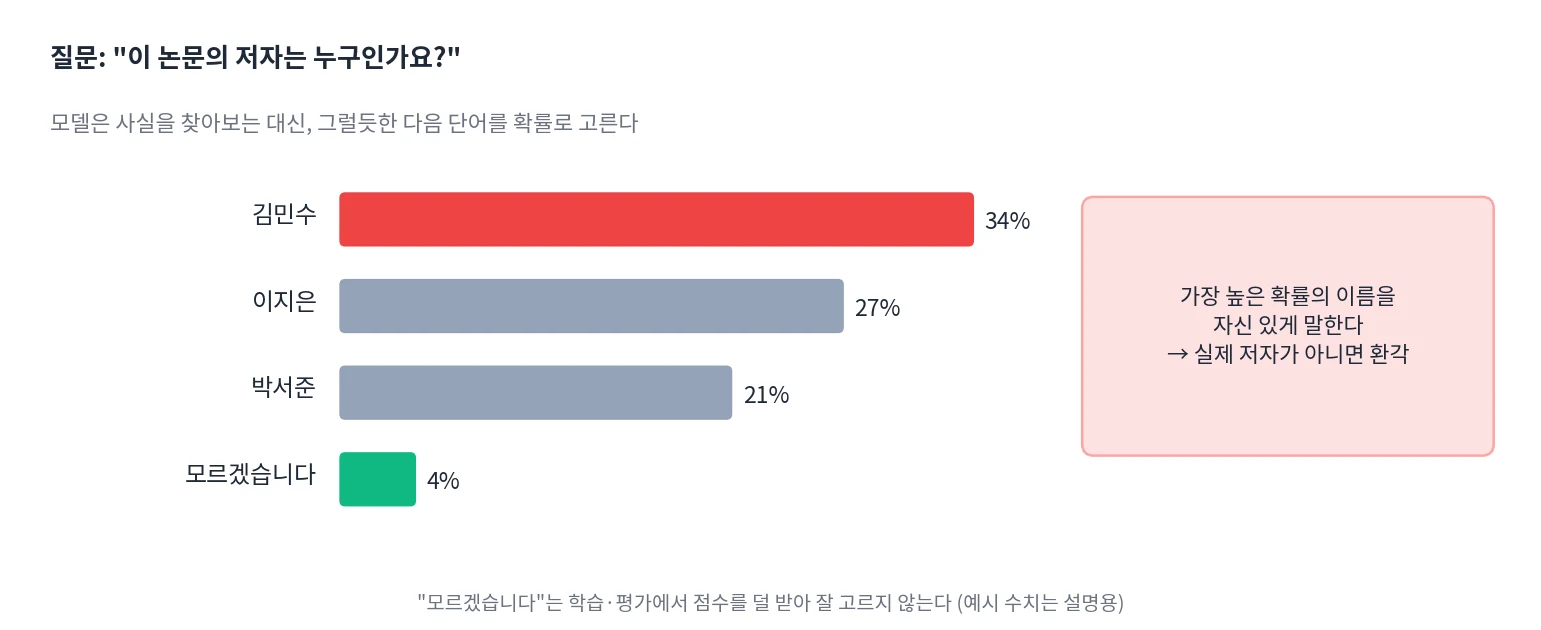
학습 데이터에 여러 번 나온 사실은 잘 맞히지만, 한 번쯤 스쳐 간 사실이나 아예 없는 사실은 비슷한 모양의 답으로 채웁니다. 학습이 끝난 뒤에 생긴 일은 애초에 알 수 없는데도 아는 것처럼 답하기도 합니다.
모른다고 하면 점수를 덜 받는 채점
2025년 9월 OpenAI와 조지아공대 연구진은 「언어 모델은 왜 환각을 일으키나(Why Language Models Hallucinate)」 논문에서 한 가지 원인을 더 짚었습니다. "학습과 평가 방식이 불확실함을 인정하는 것보다 추측하는 쪽에 보상을 준다"는 것입니다. 객관식 시험에서 모르는 문제도 찍으면 점수를 받을 수 있듯이, 정답률만 재는 평가에서는 "모르겠습니다"라고 답하는 모델이 손해를 봅니다.
회사로 치면 모르는 것을 모른다고 말하지 못하는 자신만만한 신입사원과 비슷합니다. 상사가 물을 때마다 "확인해 보겠습니다"라고 하면 일을 못 하는 사람처럼 보일까 봐, 기억나는 대로 그럴듯하게 답해 버립니다. 대부분은 맞으니 평소에는 똑똑해 보이지만, 틀린 답도 똑같이 당당한 말투로 나오기 때문에 듣는 사람이 가려내기 어렵습니다.
이 논문이 든 예는 이렇습니다. 생일 같은 사실의 20%가 학습 데이터에 딱 한 번만 나온다면, 기본 모델(사전학습만 마친 모델)은 그런 질문의 적어도 20%에서 환각을 일으킬 것으로 봅니다. 그러면서 환각은 피할 수 없는 운명이 아니라, 모를 때 답을 멈추도록 채점 방식을 바꾸면 줄일 수 있다고 제안했습니다.
얼마나 자주 생기나
환각률은 무엇을 어떻게 재느냐에 따라 크게 달라집니다. 환각률은 보통 정답을 아는 질문 묶음이나 원문이 있는 문서를 모델에 주고, 나온 답 가운데 틀리거나 지어낸 답이 몇 퍼센트인지로 셉니다. 이런 질문 묶음을 벤치마크(benchmark, 여러 모델을 같은 문제로 채점해 비교하는 시험지)라고 합니다. 어떤 벤치마크를 쓰느냐에 따라 숫자가 크게 바뀌므로, 서로 다른 시험의 숫자를 나란히 놓고 비교하면 안 됩니다. 공개된 측정값 몇 가지를 소개합니다.
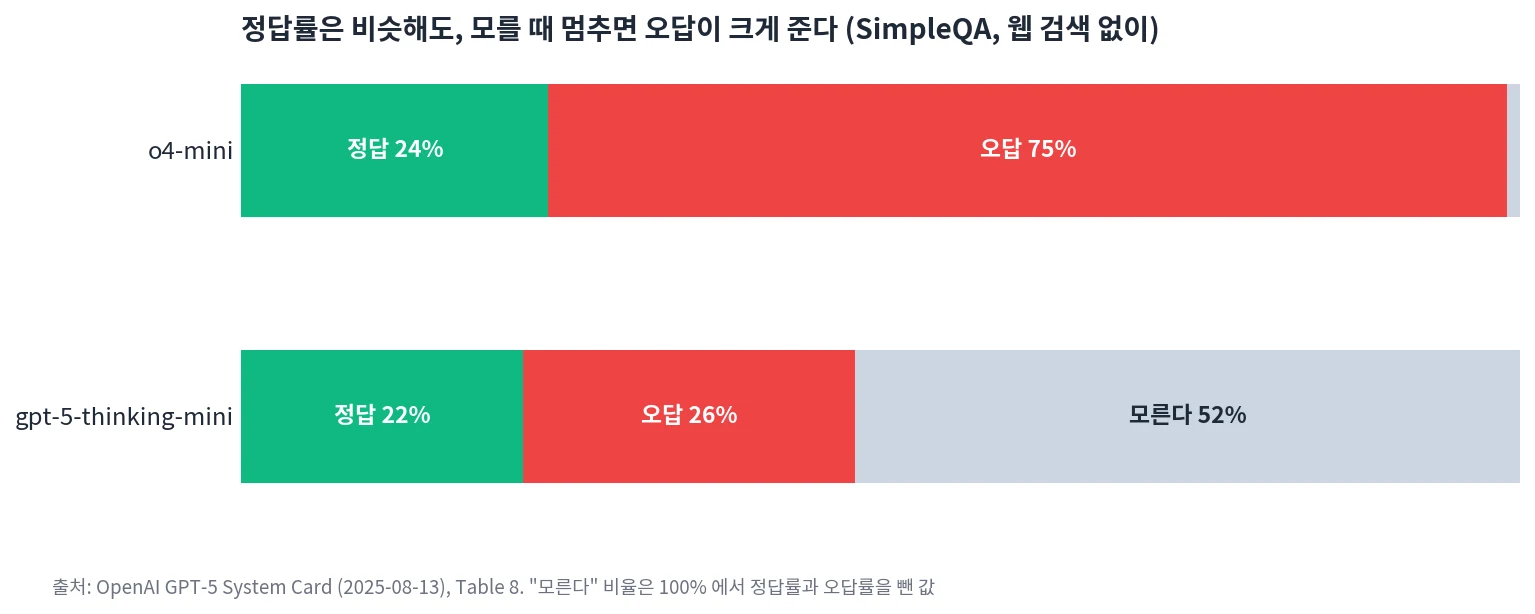
- 짧은 사실 질문(SimpleQA): OpenAI의 SimpleQA는 한 가지 정답이 있는 짧은 사실 질문 4,326개로 모델을 잽니다. 모델은 정답을 맞히거나, 틀리거나, 모른다고 답할 수 있습니다. 이 시험의 결과는 아래 GPT-5 시스템 카드 사례에서 다시 봅니다.
- 인물에 관한 질문(PersonQA): 공개된 인물 정보를 묻는 질문 묶음입니다. OpenAI가 2025년 4월 공개한 o3·o4-mini 시스템 카드(모델의 성능과 안전성 평가를 정리해 공개하는 문서)에서 PersonQA 환각률은 o1이 16%, o3가 33%, o4-mini가 48%였습니다. 새 모델이 늘 환각이 적은 것은 아니라는 뜻입니다. OpenAI는 o3가 주장을 더 많이 해서 맞는 말도, 틀린 말도 늘었다고 설명했습니다.
- 문서 요약: 벡타라(Vectara)의 환각 순위표는 문서 7,700여 건을 "문서에 있는 사실만으로" 요약하게 하고, 원문에 없는 내용이 들어간 비율을 잽니다. 2026년 9월 22일 갱신 기준 모델마다 약 2%에서 24%까지 차이가 납니다.
모를 때 멈추는 것이 얼마나 중요한지도 SimpleQA 숫자로 드러납니다. 2025년 8월 공개된 GPT-5 시스템 카드의 SimpleQA 결과를 보면, o4-mini와 gpt-5-thinking-mini는 정답률이 24%와 22%로 비슷했습니다. 그런데 o4-mini는 거의 모든 질문에 답을 시도해 75%가 오답이었고, gpt-5-thinking-mini는 절반 넘게 "모른다"고 답해 오답이 26%에 그쳤습니다.
실제로 벌어진 일들
| 시기 | 사건 | 결과 |
|---|---|---|
| 2023년 2월 | 구글 바드가 홍보 영상에서 제임스웹 우주망원경이 외계 행성 사진을 처음 찍었다고 답함 (실제 첫 사진은 2004년 유럽남방천문대 망원경) | 알파벳 시가총액 약 1,000억 달러 감소 |
| 2023년 6월 | 미국 뉴욕 연방법원 Mata v. Avianca 사건. 변호사가 ChatGPT가 만든 존재하지 않는 판례를 서면에 인용 | 변호사들에게 벌금 5,000달러 |
| 2024년 2월 | 캐나다 에어캐나다 챗봇이 유족 할인 운임을 사후에도 신청할 수 있다고 잘못 안내 | 심판소가 "챗봇이 준 정보도 회사 책임"이라며 배상 명령 |
| 2025년 10월 | 딜로이트 호주가 정부에 낸 보고서에 지어낸 판결 인용과 존재하지 않는 논문이 들어간 사실이 드러남 | 계약금 일부 환급 |
에어캐나다 사건을 맡은 곳은 캐나다 브리티시컬럼비아주의 민사분쟁 심판소(Civil Resolution Tribunal)입니다. 소액 분쟁을 정식 재판보다 간단한 절차로 판단하는 기관입니다. 심판소는 챗봇이 "스스로 행동에 책임지는 별개의 법인"이라는 회사 주장을 "놀라운 주장"이라고 일축하고, 정보가 정적인 웹 페이지에서 나왔든 챗봇에서 나왔든 차이가 없다고 판단했습니다. Mata 사건 판결문은 믿을 만한 AI 도구를 쓰는 것 자체는 문제가 아니며, 제출하는 서류의 정확성을 확인할 책임은 변호사에게 있다고 적었습니다. AI가 만든 답의 책임은 그 답을 쓴 사람과 회사에 있다는 것입니다.
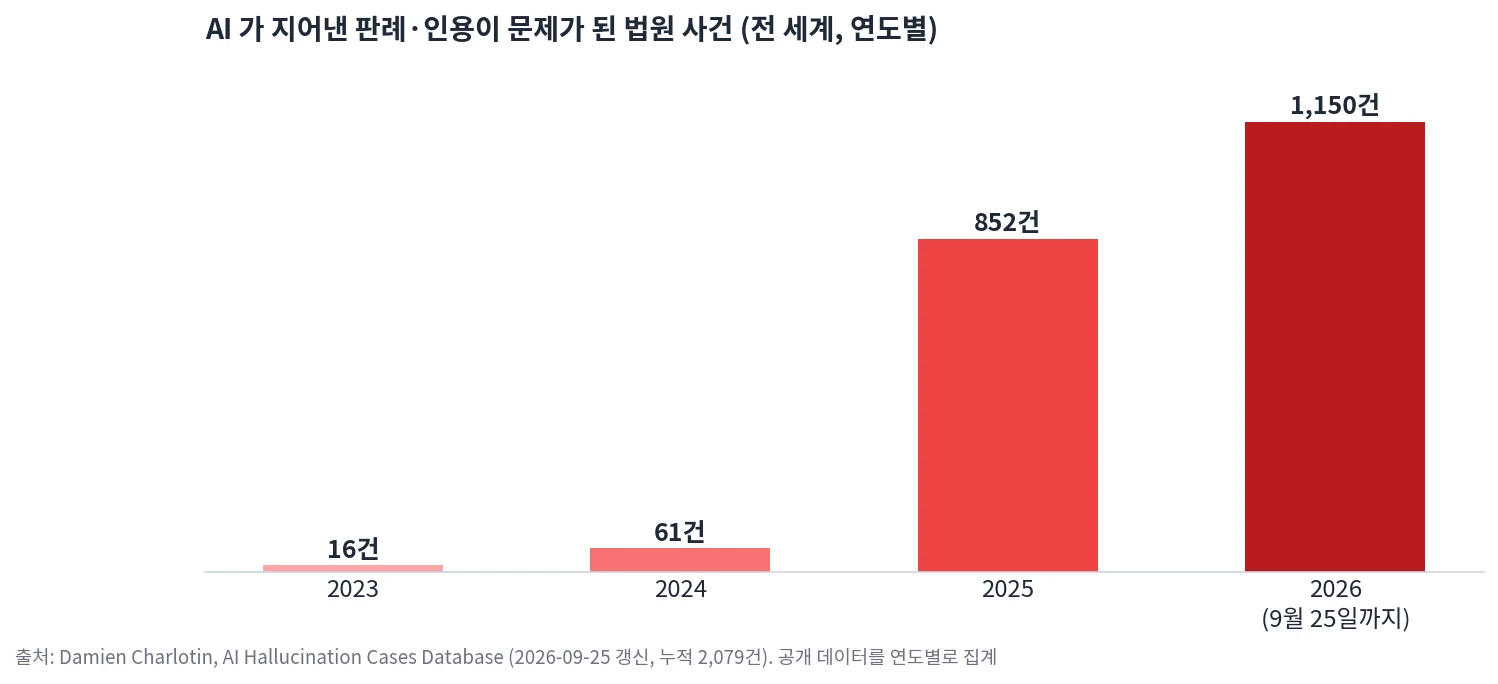
법원에서 이런 일은 빠르게 늘고 있습니다. 법률 연구자 다미앵 샤를로탱(Damien Charlotin)이 모은 데이터베이스에는 2026년 9월까지 AI가 지어낸 판례나 인용이 문제가 된 사건이 전 세계에서 2,079건 올라 있습니다. 한국에서도 존재하지 않는 사건번호나 판례를 인용한 서면을 법원이 판결문에서 지적한 사례가 법률신문(2026년 4월 1일)에 보도됐습니다. 경력 5년 차 변호사가 낸 서면과, 변호사 없이 소송하는 당사자가 ChatGPT로 쓴 서면이 모두 포함됐습니다.
어떻게 줄이나
환각을 완전히 없애는 방법은 아직 없습니다. 대신 여러 방법을 겹쳐 줄입니다.
1. 근거를 찾아서 답하게 하기 (RAG)
RAG(검색 증강 생성)는 모델의 기억에만 기대지 않고, 관련 문서를 먼저 찾아 그 내용을 근거로 답하게 하는 방법입니다. 시험으로 치면 외운 것만으로 쓰는 시험이 아니라, 교재를 펴 놓고 해당 쪽을 찾아 답을 쓰는 오픈북 시험입니다. 2020년 처음 제안한 연구(Lewis 등)는 RAG가 기억만 쓰는 모델보다 "더 구체적이고 사실에 맞는" 답을 만든다고 보고했습니다.
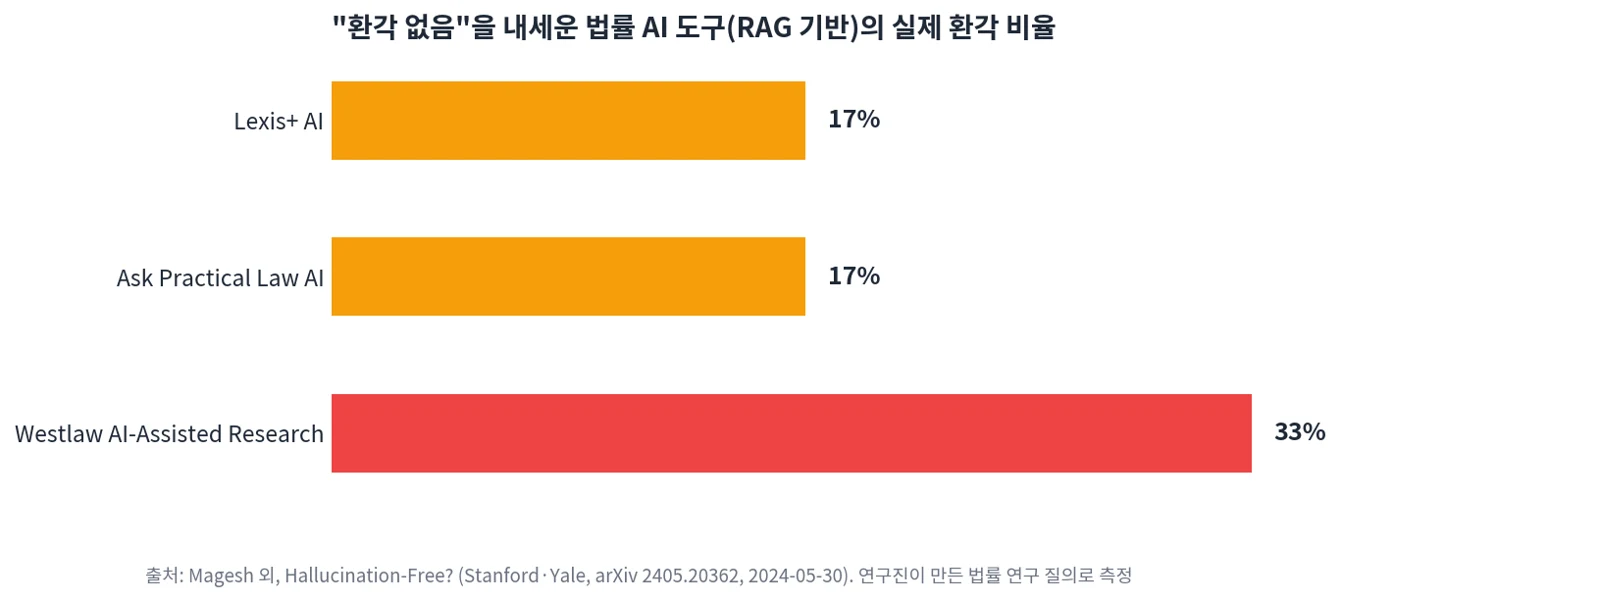
하지만 RAG도 환각을 없애지는 못합니다. 2024년 스탠퍼드와 예일대 연구진은 "환각이 없다"고 홍보한 법률 AI 연구 도구들을 시험했는데, 도구마다 17%에서 33%의 답에 환각이 있었습니다. 연구진은 법률 RAG가 범용 AI보다 환각을 줄이지만 여전히 상당하다고 결론 내렸습니다. 검색이 엉뚱한 문서를 가져오거나, 맞는 문서를 가져와도 모델이 잘못 읽을 수 있기 때문입니다.
2. 출처를 붙이고 원문을 바로 볼 수 있게 하기
답의 문장마다 어느 문서에서 나왔는지 붙이면, 틀린 답을 사람이 빨리 찾아낼 수 있습니다. 여러 문서를 가로지르는 답이라면 지식그래프와 GraphRAG처럼 대상과 관계를 따라가며 근거를 연결하는 방법도 있습니다.
3. 모를 때는 모른다고 하게 하기
앞의 결과처럼 "모르겠습니다"를 허용하면 오답이 크게 줄어듭니다. 서비스를 만드는 쪽에서는 시스템 프롬프트(system prompt, 대화가 시작되기 전에 AI에게 미리 주는 기본 규칙)에 "근거 문서에 없는 내용은 답하지 말고 모른다고 하라"를 넣습니다. 앞의 OpenAI 논문 연구진은 평가할 때도 틀린 답에 모른다는 답보다 더 큰 감점을 주자고 제안했습니다.
4. 스스로 한 번 더 확인하게 하기
메타 연구진의 검증 사슬(Chain-of-Verification, 2023)은 모델이 초안을 쓴 뒤, 초안을 확인할 질문을 스스로 만들고, 그 질문에 따로 답해, 마지막에 검증된 답을 쓰게 합니다. 2024년 네이처에 실린 연구는 같은 질문에 여러 번 답하게 해서 답의 의미가 흔들리는 정도로 지어낸 답을 가려내는 방법을 제시했습니다. 이 흔들림을 재는 값을 의미 엔트로피(semantic entropy)라고 합니다. 여러 번 물어도 표현만 조금 다를 뿐 뜻이 같은 답이 나오면 모델이 비교적 확실히 아는 것이고, 물을 때마다 뜻이 다른 답이 나오면 지어내고 있을 가능성이 높다고 봅니다.
교차 검증(cross-check, 한 모델이 만든 답을 다른 모델이나 다른 자료로 다시 확인하는 일)도 쓸 수 있습니다. 생성과 검증에 서로 다른 회사의 모델을 쓰면, 같은 모델이 자기 답을 채점하는 문제도 피할 수 있습니다.
5. 중요한 곳의 사람 확인
법률, 의료, 금융, 고객 안내처럼 틀린 답이 곧 손해가 되는 곳에서는 사람의 확인을 마지막 단계로 둡니다. 앞의 사건들이 보여 주듯, 책임은 결국 AI를 쓴 사람과 조직에 돌아옵니다.
| 방법 | 줄여 주는 것 | 한계 |
|---|---|---|
| RAG | 기억에 없는 사실, 최신 정보 | 검색이 틀리면 답도 틀림 |
| 출처 표시 | 확인에 드는 시간 | 출처가 있어도 해석이 틀릴 수 있음 |
| 모른다고 하기 | 자신 있게 틀린 답 | 답을 못 받는 질문이 늘어남 |
| 자기 검증, 교차 검증 | 논리 오류, 사실 오류 | 비용과 시간이 늘어남 |
| 사람 확인 | 중요한 오류 | 사람이 볼 수 있는 양에 한계 |
일할 때 바로 쓰는 환각 점검법
어떤 질문에서 환각이 잘 나나
아래 표는 앞에서 본 원인(드물게 나온 사실, 학습 이후의 일, 긴 자료)을 바탕으로 정리한 일반적인 경향입니다. 측정한 수치가 아니므로, 오른쪽 질문이라도 결과는 늘 확인해야 합니다.
| 환각이 잘 나는 질문 | 비교적 안전한 질문 |
|---|---|
| 잘 알려지지 않은 인물, 작은 회사, 지역 업체의 정보 | 널리 알려진 개념 설명(예: 부가가치세란 무엇인가) |
| 최근 사건, 최신 가격, 바뀐 제도 | 내가 붙여 넣은 글을 다듬거나 맞춤법 고치기 |
| 구체적인 숫자, 날짜, 통계, 시장 규모 | 이메일 초안, 문장 톤 바꾸기 |
| 법 조항 번호, 판례, 논문 제목, 보고서 이름 | 아이디어 목록 뽑기, 목차 잡기 |
| 긴 문서나 여러 문서를 한꺼번에 요약하기 | 짧은 글의 핵심 한두 줄 뽑기 |
확인이 쉬워지는 요청 문장
질문 끝에 한 문장만 덧붙여도 답을 확인하기가 훨씬 쉬워집니다. 그대로 복사해 쓸 수 있는 문장입니다.
| 덧붙일 문장 | 얻는 것 |
|---|---|
| "출처 링크를 붙여 줘." | 링크를 직접 열어 실제로 있는 자료인지 확인할 수 있습니다. |
| "자료에 없으면 모른다고 해 줘." | 억지로 채운 답 대신 빈칸이 드러납니다. |
| "원문 문장을 그대로 인용해 줘." | 요약이 원문을 비틀었는지 한 문장씩 맞춰 볼 수 있습니다. |
| "확실한 것과 추측한 것을 나눠서 표시해 줘." | 먼저 확인할 부분이 어디인지 보입니다. |
| "내가 붙여 넣은 자료만 보고 답해 줘." | 기억에 기대 지어낸 내용이 섞일 여지가 줄어듭니다. |
다만 AI는 출처 링크나 인용문 자체를 지어낼 수도 있습니다. 앞의 보도자료 장면처럼, 요청 문장은 확인을 쉽게 해 줄 뿐 확인을 대신하지 않습니다.
결과를 받은 뒤 5단계 점검
- 숫자, 날짜, 고유명사에 표시합니다. 틀리면 문제가 되는 곳부터 골라냅니다.
- 출처를 직접 엽니다. 링크가 열리는지, 그 자료가 실제로 있는지 봅니다.
- 원문과 숫자를 대조합니다. 자료는 있는데 숫자나 연도가 다른 경우가 흔합니다.
- 다른 경로로 한 번 더 찾아봅니다. 검색 엔진이나 공식 누리집에서 같은 내용이 나오는지 봅니다.
- 확인하지 못한 문장은 뺍니다. 고객, 상사, 기자에게 나가는 글이라면 특히 그렇습니다.
기업이 AI 답변 서비스를 만들 때
- 답의 근거가 될 자료(규정, 매뉴얼, 제품 정보)를 먼저 정리하고, 그 자료에서만 답하게 합니다.
- 문장마다 출처를 붙이고, 원문으로 바로 갈 수 있게 합니다.
- 자료에 없으면 "담당자에게 연결해 드리겠습니다"처럼 모른다고 답하는 경로를 만듭니다.
- 환불, 요금, 법적 안내처럼 책임이 따르는 답은 사람이 확인하거나, 정해진 문구만 쓰게 합니다.
- 실제 질문으로 주기적으로 시험해, 환각이 어디서 얼마나 나는지 잽니다.
젠아이랩스(GenAI Labs)의 AI 챗봇은 회사가 등록한 문서와 웹 페이지에서 근거를 찾아 답하는 기업용 상담 챗봇입니다. 지식그래프·온톨로지 솔루션은 흩어진 문서의 관계를 그래프로 엮어, 답의 문장마다 근거 문서를 붙입니다. 젠아이랩스의 AI 뉴스룸은 요약은 Claude가, 사실 검증은 다른 회사 모델이 맡는 교차 검증 방식으로 글을 만듭니다.
자주 묻는 질문
유료 요금제나 최신 모델을 쓰면 괜찮지 않나요?
줄어들 수는 있지만 사라지지는 않습니다. 앞에서 본 OpenAI 시스템 카드에서 인물에 관한 질문(PersonQA)의 환각률은 이전 모델 o1이 16%였는데, 나중에 나온 o3는 33%, o4-mini는 48%였습니다. 모델이 새롭거나 비싸다고 해서 환각이 늘 적은 것은 아닙니다. 어떤 모델을 쓰든 숫자와 출처는 직접 확인해야 합니다.
검색 기능을 켜면 환각이 사라지나요?
검색을 켜면 AI가 문서를 찾아 읽고 답하므로, 기억에만 기댈 때보다는 나아집니다. 하지만 사라지지는 않습니다. 앞에서 본 스탠퍼드·예일대 연구에서 문서를 찾아 답하는 법률 AI 도구들도 17%에서 33%의 답에 환각이 있었습니다. 엉뚱한 문서를 찾거나, 맞는 문서를 잘못 읽을 수 있기 때문입니다. 검색 결과로 답을 받았다면 붙은 링크를 열어 실제 내용과 맞는지 확인합니다.
정리
AI 환각은 언어 모델이 사실을 찾는 대신 그럴듯한 다음 단어를 고르고, 학습과 평가가 모를 때도 답하는 쪽에 보상을 주면서 생깁니다. 최신 모델에서도 사라지지 않았고, 법원과 기업에서 실제 손해로 이어지고 있습니다. 근거를 찾아 답하게 하고, 출처를 붙이고, 모를 때는 멈추게 하고, 중요한 답은 사람이 확인하는 것이 지금 쓸 수 있는 현실적인 방법입니다. 여러 문서에 걸친 근거를 연결하는 방법은 지식그래프와 GraphRAG란? 글에서 이어집니다.