지식그래프(knowledge graph)는 사람, 회사, 제품, 문서 같은 대상을 점(노드)으로, 그 사이의 관계를 선(엣지)으로 저장한 데이터입니다. GraphRAG는 이 지식그래프를 생성형 AI의 검색 증강 생성(RAG)에 붙여, 문서끼리 어떻게 이어지는지까지 따라가며 답하게 하는 방법입니다. 여기서 RAG는 AI가 답하기 전에 회사 문서를 먼저 찾아보게 하는 방식으로, RAG란? 글에서 자세히 다뤘습니다.
한눈에 보기
- 지식그래프는 "김팀장이 A 프로젝트를 맡았다"처럼 사람, 회사, 일 사이의 관계를 선으로 이어 적어 둔 자료입니다.
- GraphRAG는 AI가 그 선을 따라가며 여러 문서에 흩어진 답을 모으게 해, 일반 RAG가 약한 "여러 문서를 이어야 하는 질문"과 "전체를 묻는 질문"을 보완합니다.
- 만드는 비용이 크고 단순한 질문에서는 이점이 적으므로, 관계가 중요한 영역부터 작게 시작해 일반 RAG와 섞어 쓰는 것이 현실적입니다.
이런 상황을 떠올려 보세요. 다른 회사에서 새로 온 영업 본부장이 첫 주에 대표에게서 "다음 달에 B사와 미팅이 있으니, 우리가 B사와 전에 무슨 일을 했고 누가 맡았는지 정리해 달라"는 부탁을 받습니다. 계약서는 공유 폴더에, 주간 보고는 메일함에, 기술 자료는 사내 위키에 흩어져 있습니다. 계약서에는 "B사"가 나오지만 담당자 이름이 없고, 주간 보고에는 담당자인 김팀장과 이대리의 이름이 나오지만 "A 프로젝트"라고만 적혀 있어 B사 일인지 알 수 없습니다. 결국 본부장은 이틀 동안 메일을 뒤지고 옆자리 동료에게 물어 가며 조각을 맞춥니다. 사람의 머릿속에서는 "B사, A 프로젝트, 김팀장, 이대리"가 줄로 이어져 있지만, 문서에는 그 줄이 적혀 있지 않기 때문입니다. 지식그래프는 바로 이 줄을 적어 두는 방법이고, GraphRAG는 AI가 그 줄을 따라가며 답하게 하는 방법입니다.
일반 RAG는 질문과 비슷한 문단을 찾아 답합니다. 답이 한두 문단 안에 있으면 잘 맞습니다. 하지만 "이 고객사와 한 프로젝트는 누가 맡았고, 그 사람은 지금 어느 팀에 있나"처럼 여러 문서를 가로질러야 하는 질문이나, "이 자료 전체의 주요 주제는 무엇인가"처럼 전체를 봐야 하는 질문에는 약합니다. 지식그래프와 GraphRAG는 이 빈틈을 메우려고 등장했습니다.
문자열이 아니라 대상으로
지식그래프라는 말을 널리 알린 것은 2012년 5월 구글의 발표입니다. 구글은 검색이 "문자열이 아니라 대상(things, not strings)"을 이해해야 한다며, 5억 개가 넘는 대상과 35억 개가 넘는 사실을 담은 지식그래프를 검색에 붙였습니다. "타지마할"을 검색하면 건축물인지, 같은 이름의 음악가인지, 카지노인지를 구분하고, 인물을 검색하면 관련 인물과 사건을 옆에 정리해 보여 주는 기능이 여기서 나왔습니다. 글자가 같다는 것만 보는 것이 아니라, 그 글자가 가리키는 "대상"이 무엇이고 그 대상이 무엇과 이어져 있는지를 알게 된 것입니다.
학계에서 널리 쓰이는 정의는 2021년 ACM Computing Surveys에 실린 Hogan 등의 서베이(한 분야의 연구를 두루 모아 정리한 논문)에 있습니다. 이 논문은 지식그래프를 "실세계에 대한 지식을 쌓고 전달하기 위한 데이터 그래프로, 노드는 관심 대상을, 엣지는 그 대상 사이의 관계를 나타낸다"고 정의합니다. 같은 논문은 구글 이후 에어비앤비, 아마존, 이베이, 페이스북, IBM, 링크드인, 마이크로소프트, 우버 등이 잇달아 기업 지식그래프를 발표했다고 정리합니다.
지식그래프의 가장 작은 단위는 트리플(triple)입니다. 주어, 관계, 목적어 세 칸으로 사실 하나를 적습니다. 이름은 낯설지만, 모양은 "누가, 무엇을, 무엇과"를 한 줄에 적는 엑셀 표 한 행과 같습니다.
| 주어 | 관계 | 목적어 |
|---|---|---|
| 김팀장 | 담당 | A 프로젝트 |
| A 프로젝트 | 고객 | B사 |
| 이대리 | 참여 | A 프로젝트 |
| A 프로젝트 | 사용 기술 | 그래프 DB |
이렇게 적어 두면 "B사 프로젝트에 참여한 사람"을 찾을 때 문서를 다시 읽지 않고 선을 따라가면 됩니다. B사에서 출발해 "고객" 선을 거꾸로 따라가면 A 프로젝트가 나오고, A 프로젝트에 달린 "담당"과 "참여" 선을 따라가면 김팀장과 이대리가 나옵니다. 표의 "그래프 DB"는 이런 점과 선을 모양 그대로 저장하고 빠르게 따라갈 수 있게 만든 데이터베이스를 말합니다. 저장 방식은 기관끼리 데이터를 잇기 좋은 국제 표준 방식과 회사 안에서 빠르게 쓰기 좋은 방식 두 갈래가 있으며, 자세한 내용은 글 끝 심화 절에 모았습니다.
온톨로지, 택소노미와는 무엇이 다른가
세 용어는 자주 섞여 쓰이지만 역할이 다릅니다.
| 구분 | 무엇인가 | 예 |
|---|---|---|
| 택소노미 | 개념을 위아래로 나눈 분류 체계 | 제품 > 가전 > 냉장고 |
| 온톨로지 | 어떤 대상과 관계를 둘지, 그 규칙까지 정한 설계도 | "프로젝트에는 담당자가 한 명 이상 있다", "고객은 회사다" |
| 지식그래프 | 설계도에 따라 실제 데이터를 채운 연결망 | 김팀장이 A 프로젝트를 담당한다 |
쇼핑몰에 비유하면 택소노미는 상품 카테고리 메뉴, 온톨로지는 "상품에는 제조사가 하나 있고, 주문에는 주문한 고객이 한 명 있다" 같은 입력 규칙, 지식그래프는 그 규칙에 따라 실제 상품과 고객과 주문이 서로 이어진 장부입니다.
온톨로지의 고전적인 정의는 1993년 톰 그루버의 "개념화를 명시적으로 적은 명세(an explicit specification of a conceptualization)"입니다. 쉽게 말해 "우리 조직에서는 무엇을 대상으로 보고, 대상끼리 어떤 관계를 맺는지"를 약속해 적은 문서입니다. 온톨로지가 지식그래프의 스키마(데이터를 어떤 칸과 규칙으로 담을지 정한 뼈대) 역할을 하는 셈입니다. Hogan 등의 서베이는 기업 지식그래프에서 쓰는 온톨로지가 대개 가벼운 수준이라고 적습니다. 흔히 클래스 계층(위아래로 나눈 종류 목록)을 담은 단순한 택소노미에 가깝다는 것입니다. 처음부터 완벽한 온톨로지를 만들 필요는 없다는 뜻이기도 합니다.
RAG가 막히는 질문들
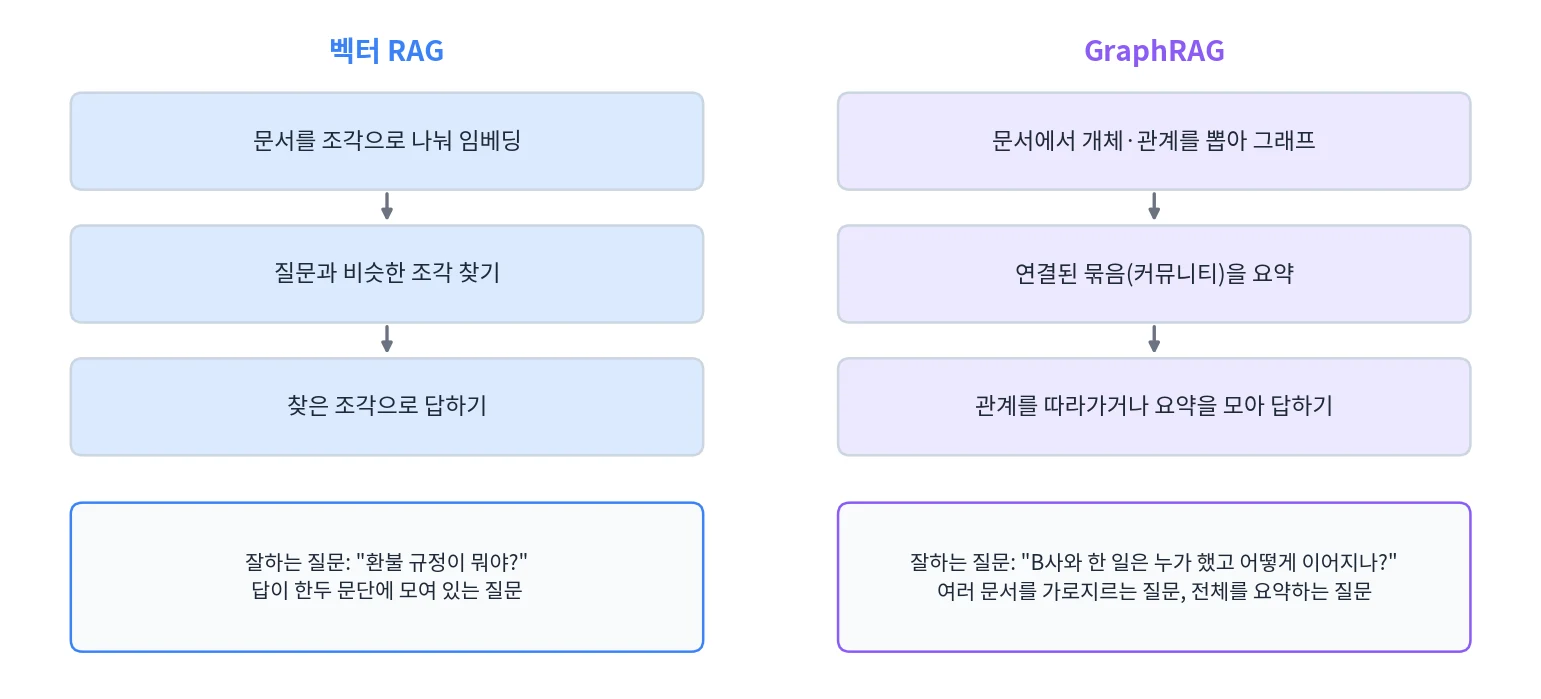
RAG가 문서를 찾는 방식을 조금 더 들여다보면 이렇습니다. 문서를 작은 조각으로 나눠 벡터(뜻을 숫자 목록으로 적은 좌표)로 바꿔 두고, 질문과 가장 비슷한 조각을 찾아 모델에게 건넵니다. 그런데 비슷한 문단을 찾는 방식에는 구조적인 한계가 있습니다.
- 여러 단계를 거치는 질문: "B사 프로젝트 담당자가 지금 이끄는 팀의 다른 프로젝트는?"처럼 한 문서의 답이 다음 검색의 조건이 되는 질문은, 첫 문단만 찾아서는 풀리지 않습니다.
- 전체를 묻는 질문: "이 자료들에서 반복되는 주요 문제는 무엇인가?" 같은 질문에는 비슷한 문단이 따로 없습니다. 답이 모든 문서에 조금씩 흩어져 있기 때문입니다.
- 관계와 시점: "누가 언제 어느 팀으로 옮겼나"처럼 관계의 변화는 문단의 비슷함으로는 잘 잡히지 않습니다.
마이크로소프트 연구진은 2024년 GraphRAG 논문에서 이 한계를 "RAG는 '이 데이터의 주요 주제는 무엇인가'처럼 말뭉치 전체를 향한 전역 질문에서 실패한다"라고 적었습니다. 말뭉치는 AI에게 읽힐 문서 전체 묶음을, 전역 질문은 문서 한 곳이 아니라 전체를 훑어야 답할 수 있는 질문을 말합니다. 고객 문의 3년 치를 앞에 두고 "요즘 고객들이 가장 많이 불편해하는 점이 뭐지?"라고 묻는 경우가 여기에 해당합니다.
GraphRAG는 어떻게 동작하나
GraphRAG라는 이름은 2024년 2월 마이크로소프트 리서치 블로그로 알려졌고, 같은 해 4월 논문(From Local to Global)과 7월 오픈소스(누구나 코드를 받아 쓰고 고칠 수 있게 공개한 소프트웨어) 공개로 널리 퍼졌습니다. 마이크로소프트 방식의 흐름은 이렇습니다.
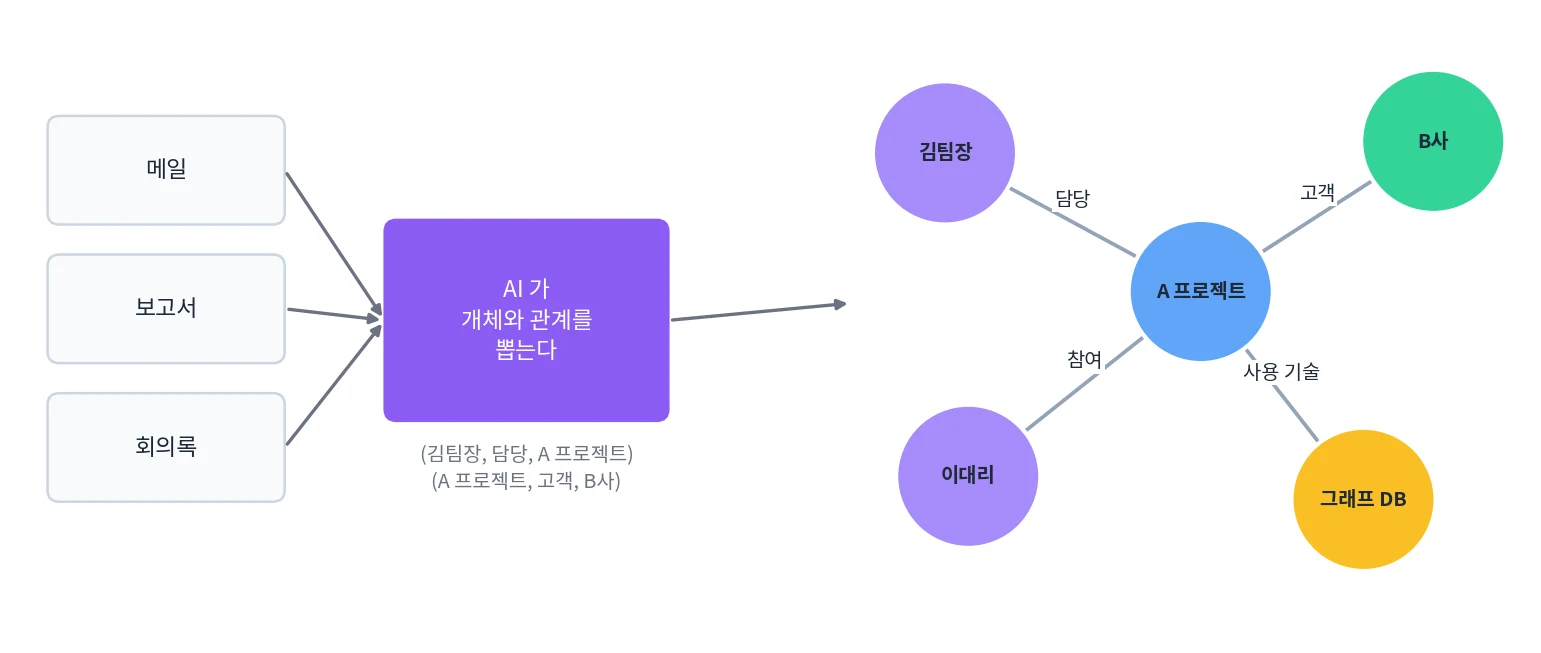
- 개체와 관계 추출: 문서를 조각으로 나누고, 언어 모델(ChatGPT 같은 AI의 바탕이 되는 모델)이 각 조각에서 사람, 조직, 장소, 사건 같은 개체와 그 사이의 관계를 뽑아 지식그래프를 만듭니다. 앞의 트리플 표를 AI가 문서를 읽으며 대신 채운다고 보면 됩니다.
- 커뮤니티 찾기: 그래프에서 선이 많이 오가는 개체끼리 한 묶음(커뮤니티)으로 묶습니다. 큰 묶음 안에서 다시 작은 묶음을 찾아 여러 층으로 나눕니다.
- 커뮤니티 요약: 묶음마다 무엇에 관한 것인지 미리 요약해 둡니다.
- 답하기: 전체를 묻는 질문이 오면 각 커뮤니티 요약으로 부분 답을 만들고, 이를 다시 모아 최종 답을 씁니다. 특정 대상을 묻는 질문이면 그 개체에서 출발해 연결된 개체와 원문을 따라가며 답합니다.
커뮤니티와 그 요약은 회사 조직도에 빗대면 쉽습니다. 누가 누구와 자주 일하는지 선을 그어 보면, 자연스럽게 영업본부, 그 안의 영업1팀, 영업2팀 같은 무리가 생깁니다. 이것이 여러 층으로 나뉜 커뮤니티입니다. 커뮤니티 요약은 부서마다 "이번 분기 우리 부서는 무엇을 했고 어떤 문제가 있었나"를 담은 업무 보고서를 미리 써 두는 것과 같습니다. 사장이 "올해 회사 전체의 주요 이슈가 뭐였지?"라고 물으면, 직원 수백 명의 메일을 다시 읽는 대신 부서별 보고서를 모아 종합 보고서를 쓰면 됩니다. GraphRAG가 전역 질문에 답하는 방식이 바로 이것입니다.
같은 질문, 두 가지 답
앞의 김팀장과 A 프로젝트 예로 돌아가 보겠습니다. 회사에 문서가 세 가지 있다고 합시다. 계약서에는 "A 프로젝트의 고객은 B사"라고, 주간 보고에는 "A 프로젝트는 김팀장이 맡고 이대리가 참여"라고, 기술 문서에는 "A 프로젝트는 그래프 DB를 쓴다"라고 적혀 있습니다. 여기에 "B사 프로젝트에 참여한 사람과 그 사람이 쓴 기술은?"이라고 묻습니다.
| 일반 RAG | GraphRAG | |
|---|---|---|
| 찾는 방법 | 질문과 가장 비슷한 문단을 찾는다. "B사"라는 말이 들어간 계약서 문단이 먼저 걸린다 | "B사"라는 점에서 출발해 선을 따라간다. B사 → A 프로젝트 → 김팀장, 이대리 → 그래프 DB |
| 답의 모습 | "B사와 한 프로젝트는 A 프로젝트입니다. 참여한 사람과 기술은 자료에서 찾지 못했습니다." | "B사 프로젝트는 A 프로젝트이며 김팀장이 맡고 이대리가 참여했습니다. 이 프로젝트는 그래프 DB를 썼습니다." |
| 근거 | 계약서 한 곳 | 계약서, 주간 보고, 기술 문서 세 곳을 각각 표시 |
| 보완 방법과 비용 | 질문을 "A 프로젝트 담당자는?"처럼 고쳐 다시 검색하는 방법(query rewriting)을 더하면 찾을 때도 있다 | 그래프를 미리 만들어 두는 준비 비용이 든다 |
일반 RAG가 틀린 것은 아닙니다. 주간 보고와 기술 문서에는 "B사"라는 말이 없어서, 질문과 비슷한 문단으로 뽑히지 않았을 뿐입니다. 문서가 세 개가 아니라 수천 개라면 이런 일은 훨씬 자주 생깁니다. GraphRAG는 문서 사이의 연결을 미리 선으로 적어 두었기 때문에, 말이 달라도 같은 일을 가리키는 문서들을 한 번에 모을 수 있습니다. 그래프를 한 번 만들어 두면 같은 종류의 질문에 곧바로 답할 수 있습니다.
얼마나 나아지나, 그리고 비용은
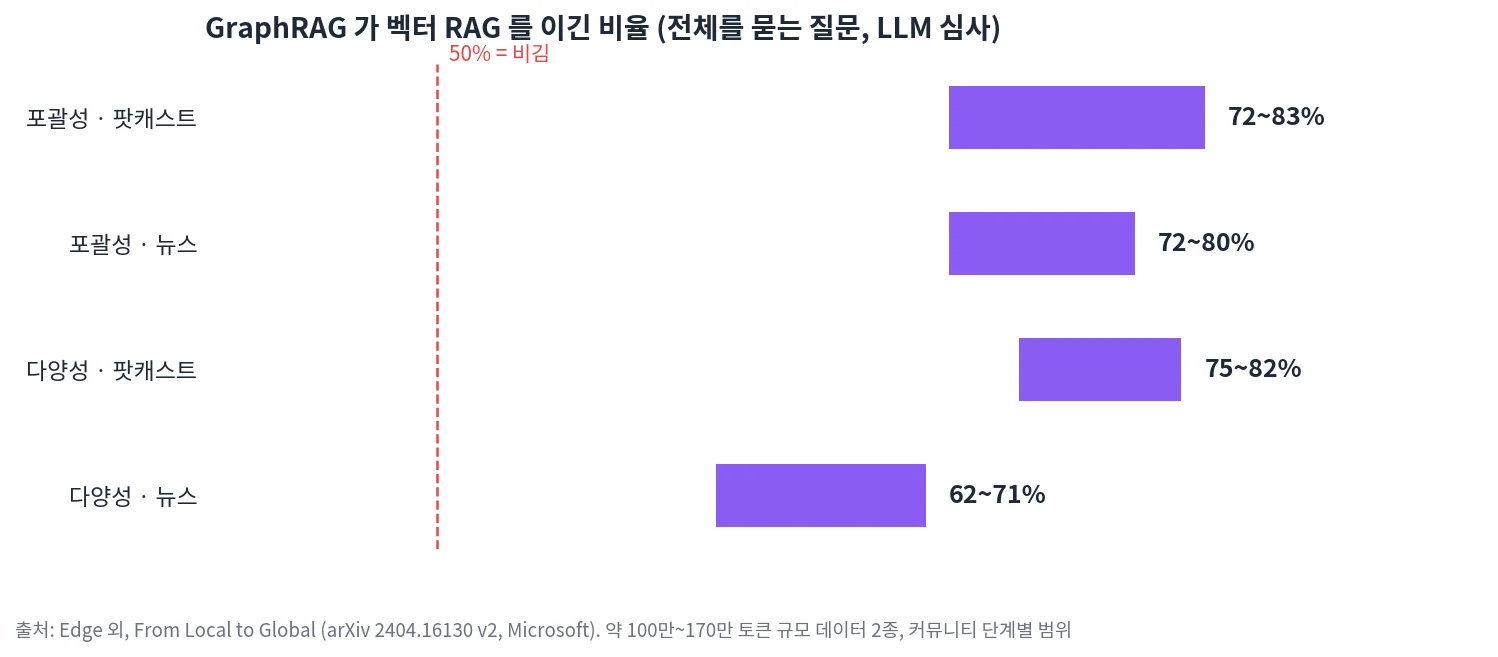
마이크로소프트 논문은 팟캐스트 대본(약 100만 토큰)과 뉴스 기사(약 170만 토큰)로 전체를 묻는 질문을 만들어 GraphRAG와 벡터 RAG의 답을 비교했습니다. 토큰(token)은 AI가 글을 읽고 쓰는 조각 단위로, 보통 단어 하나보다 조금 작습니다. 벡터 RAG는 앞에서 말한 일반 RAG를 가리킵니다. 언어 모델 심사자에게 어느 답이 나은지 고르게 한 결과, GraphRAG는 답의 포괄성에서 72~83%, 다양성에서 62~82%의 비율로 이겼습니다. 언어 모델 심사자는 사람 대신 AI에게 두 답을 나란히 보여 주고 어느 쪽이 나은지 판정하게 하는 평가 방식입니다. 포괄성은 질문의 여러 측면을 빠뜨리지 않고 두루 다뤘는지를, 다양성은 여러 관점과 생각거리를 담았는지를 봅니다.
다만 공짜는 아닙니다. 마이크로소프트는 오픈소스 안내문에 "GraphRAG 인덱싱은 비용이 큰 작업일 수 있으니 작게 시작하라"고 적었습니다. 인덱싱은 질문을 받기 전에 문서를 미리 읽어 찾기 좋게 정리해 두는 준비 작업으로, GraphRAG에서는 그래프를 만들고 커뮤니티 요약을 써 두는 단계를 말합니다. 모든 문서 조각을 언어 모델이 읽고 개체와 관계를 뽑아야 하기 때문에, AI 사용료도 문서 양에 비례해 늘어납니다. 조직도 비유로 말하면, 질문이 오기 전에 모든 부서의 보고서를 다 써 두는 비용입니다. 이 비용을 줄이려고 마이크로소프트는 2024년 11월 LazyGraphRAG를 발표했는데, 인덱싱 비용이 벡터 RAG와 같고 전체 GraphRAG의 0.1% 수준이라고 밝혔습니다. 미리 모든 요약을 만들어 두지 않고, 질문이 왔을 때 필요한 부분만 그때 처리하는 방식입니다. 보고서를 미리 다 쓰지 않고, 질문과 관련된 부서에만 그때 보고서를 받는 것과 비슷합니다.
GraphRAG가 맞지 않는 경우
후속 연구들은 GraphRAG를 언제 써야 하는지를 좀 더 냉정하게 봅니다. 2025년 발표된 GraphRAG-Bench 연구(Xiang 외, arXiv 2506.05690)는 "GraphRAG가 많은 실제 과제에서 일반 RAG보다 못한 경우가 잦다"는 문제 제기에서 출발해, 단순한 사실 찾기에서는 일반 RAG가 비슷하거나 더 낫고, 여러 단계를 거치는 복잡한 추론에서 그래프의 이점이 드러난다고 정리했습니다. 같은 해 나온 RAG와 GraphRAG 비교 연구(Han 외, arXiv 2502.11371)도 한 번에 찾을 수 있는 세부 질문에는 RAG가, 여러 문서를 이어야 하는 질문에는 GraphRAG가 강하다고 보고했습니다. 이 연구는 또 자동으로 만든 그래프에 정답 개체가 빠지는 경우가 적지 않다는 점, 언어 모델 심사는 두 답의 순서만 바꿔도 판정이 달라질 수 있다는 점을 짚었습니다. 앞의 승률 수치를 볼 때도 함께 기억할 부분입니다.
예를 들어 "연차는 며칠까지 이월되나요?"처럼 취업규칙 한 문단에 답이 있는 질문이라면, 그래프를 따라갈 필요 없이 그 문단만 찾으면 됩니다. 이런 질문에 GraphRAG를 쓰면 준비 비용만 더 들고 답은 크게 나아지지 않습니다.
| 상황 | 알맞은 방식 |
|---|---|
| 규정, 매뉴얼, FAQ처럼 답이 한 곳에 모여 있다 | 벡터 RAG로 충분하고 더 싸다 |
| 사람, 조직, 프로젝트가 여러 문서에 걸쳐 얽혀 있다 | GraphRAG가 유리하다 |
| 자료 전체의 흐름이나 주제를 묻는다 | GraphRAG의 커뮤니티 요약이 유리하다 |
| 답의 근거를 관계 단위로 설명해야 한다 | 지식그래프가 유리하다 |
| 문서가 자주 바뀌고 비용이 빠듯하다 | 벡터 RAG로 시작하고, 필요한 영역만 그래프로 |
실무에서는 둘 중 하나를 고르기보다 섞어 쓰는 경우가 많습니다. 아마존은 2025년 3월 Bedrock 지식 기반(아마존 클라우드에서 회사 문서를 AI 검색용으로 모아 두는 서비스)에 벡터 검색과 그래프 탐색을 함께 쓰는 GraphRAG 기능을 정식 출시했습니다. 링크드인은 고객 지원 질문 응답에 과거 문의 기록을 지식그래프로 엮은 RAG를 약 6개월 운영해, 문의 한 건을 해결하는 시간의 중앙값(모든 건을 걸린 시간 순으로 세웠을 때 한가운데 값)을 28.6% 줄였다고 2024년 논문에서 밝혔습니다.
도입할 때 생각할 것
- 작게 시작합니다. 모든 문서를 한 번에 그래프로 만들기보다, 관계가 중요한 영역(프로젝트 이력, 인력, 고객사)부터 시작합니다.
- 온톨로지는 가볍게 정합니다. 처음부터 모든 대상과 규칙을 정하려 하지 말고, 자주 묻는 질문에 필요한 대상과 관계부터 정합니다.
- 추출 품질을 확인합니다. 언어 모델이 뽑은 관계에는 틀린 것이 섞입니다. 다른 모델로 한 번 더 검증하거나 사람이 표본을 확인하는 단계를 둡니다.
- 답에 근거를 붙입니다. 지식그래프의 가장 큰 장점은 "어느 문서의 어느 문장에서 나온 관계인가"를 추적할 수 있다는 점입니다. 답변마다 근거 문서를 연결해 두면 사람이 바로 확인할 수 있습니다.
- 민감한 문서는 안에서 처리합니다. 개체 추출에 외부 AI를 쓰면 원문이 밖으로 나갑니다. 내부 GPU(AI 계산에 쓰는 전용 칩을 단 회사 안 서버)나 설치형 모델(회사 서버에 직접 깔아 쓰는 AI)로 처리하는 선택지도 검토합니다.
젠아이랩스(GenAI Labs)는 흩어진 회사 문서에서 사람, 조직, 프로젝트, 기술 사이의 관계를 뽑아 지식그래프로 만들고, 질문하면 문장마다 근거 문서를 붙여 답하는 지식그래프·온톨로지 솔루션을 운영합니다. 같은 기술을 자사 AI 뉴스룸에 적용한 과정은 뉴스룸 지식그래프 사례에, 가상의 컨설팅사 문서 1,357건으로 만든 데모는 데모 시나리오에 정리돼 있습니다.
정리
지식그래프는 대상과 관계를 선으로 이어 저장한 데이터이고, 온톨로지는 그 대상과 관계를 정한 설계도입니다. GraphRAG는 이 그래프를 RAG에 붙여, 여러 문서를 가로지르는 질문과 자료 전체를 묻는 질문에 답하게 합니다. 대신 만드는 비용이 크고 단순한 질문에서는 이점이 적으므로, 관계가 중요한 영역부터 작게 시작해 일반 RAG와 섞어 쓰는 것이 현실적인 길입니다. 벡터와 임베딩은 토큰과 임베딩 글에서, AI의 답을 믿을 수 있게 만드는 이야기는 AI 환각이란? 글에서 이어집니다.
개발자를 위한 심화
이 부분은 직접 구현하는 개발자를 위한 내용입니다.
지식그래프를 담는 두 가지 방식
본문에서 말한 두 저장 방식을 표준 이름과 함께 적으면 이렇습니다.
- RDF 방식: 월드와이드웹 컨소시엄(W3C)이 정한 표준입니다. 모든 사실을 트리플로 적고, 대상은 웹 주소 형태의 식별자(IRI)로 부릅니다. RDF 1.0과 온톨로지 언어 OWL은 2004년 2월 표준이 됐고, 질의 언어는 SPARQL(1.1 판은 2013년)을 씁니다. 공공 데이터나 서로 다른 기관의 데이터를 잇는 데 강합니다.
- 프로퍼티 그래프 방식: 노드와 엣지 모두에 이름과 속성(키와 값)을 붙일 수 있는 방식입니다. Neo4j 같은 그래프 데이터베이스가 이 방식을 쓰고, 질의 언어로 Cypher를 씁니다. 2024년 4월에는 국제표준화기구(ISO)가 SQL 이후의 데이터베이스 질의 언어 표준인 GQL(ISO/IEC 39075)을 발행했는데, openCypher 등 여러 그래프 질의 언어의 기능을 아우릅니다.
커뮤니티를 찾는 계산
마이크로소프트 GraphRAG는 커뮤니티를 라이덴(Leiden) 알고리즘으로 찾습니다. 라이덴 알고리즘은 선이 많이 오가는 점들끼리 자동으로 한 무리로 묶어 주는 계산 방법이고, 이를 되풀이해 큰 묶음 안의 작은 묶음까지 여러 층으로 나눕니다. 층마다 커뮤니티 요약을 따로 써 두기 때문에, 전역 질문에 답할 때 어느 층의 요약을 쓸지 고를 수 있습니다.