한눈에 보기
- OWASP LLM Top 10(정식 이름 OWASP Top 10 for LLM Applications)은 생성형 AI를 쓰는 애플리케이션의 보안 위험 10가지를 정리한 목록입니다. 웹 보안의 기준이 된 OWASP Top 10의 AI 판입니다.
- 최신판은 2026년 판입니다(2026년 8월 초 공개). 이전 판은 2025년 판(2024년 11월 18일)입니다.
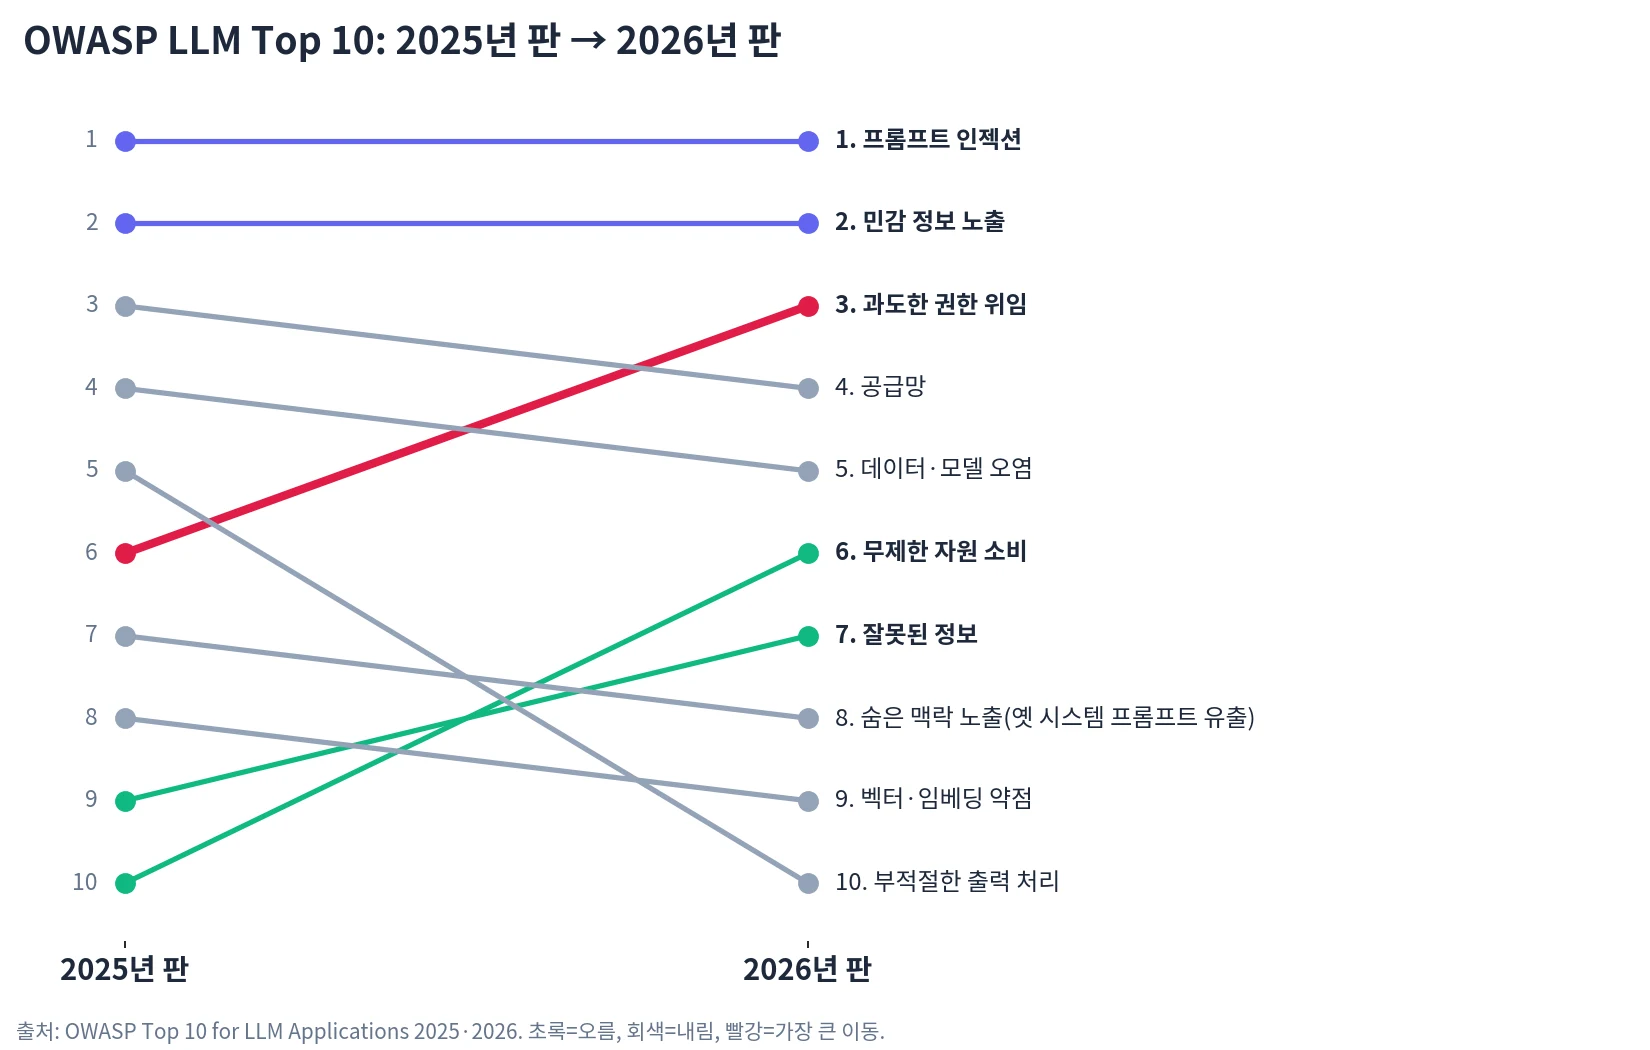
- 가장 크게 움직인 것은 과도한 권한 위임(Excessive Agency)입니다. 6위에서 3위로 올랐습니다. AI가 말하는 데서 그치지 않고 도구를 불러 실제로 일을 하게 되면서 생긴 변화입니다.
- 1위는 여전히 프롬프트 인젝션입니다. OWASP는 "오늘날 확실한 예방책은 없다"며 방어는 입력을 걸러 내는 방식이 아니라 시스템 구조로 해야 한다고 말합니다.
- 2026년 판의 핵심 문장은 이것입니다. "속지 않는 모델을 만들려고 애쓰지 말고, 모델이 속더라도 중요한 것이 깨지지 않도록 모델 둘레의 시스템을 만들라."
OWASP LLM Top 10은 어떻게 만들어졌나
OWASP LLM Top 10은 2023년 8월 1일 1.0 판으로 시작해, 2023년 10월 1.1 판, 2025년 판(2024년 11월 18일)을 거쳐 2026년 판에 이르렀습니다.
2026년 판은 순위를 정하는 방식이 달라졌습니다. OWASP는 실제 사고 7,714건을 모아, 분류할 만큼 자세한 6,639건을 항목별로 나눴습니다. 그리고 커뮤니티 투표에 4분의 3, 사고 데이터에 4분의 1의 무게를 두어 순위를 정했습니다. 현장에서 체감하는 위험과 실제로 일어난 사고를 함께 본 것입니다.
10가지 위협 한눈에
| 2026 | 위협 | 한 줄로 | 2025 |
|---|---|---|---|
| 1 | 프롬프트 인젝션(Prompt Injection) | 입력(글·문서·이미지·도구 결과·기억)이 개발자 의도와 다르게 모델의 행동을 바꾼다 | 1 |
| 2 | 민감 정보 노출(Sensitive Information Disclosure) | 답변·추론 흔적·로그·임베딩으로 기밀이 샌다 | 2 |
| 3 | 과도한 권한 위임(Excessive Agency) | AI에게 준 기능·권한·자율이 지나쳐, 잘못된 출력이 실제 피해 행동이 된다 | 6 |
| 4 | 공급망(Supply Chain) | 가져다 쓴 모델·어댑터·패키지가 오염되거나 바꿔치기된다 | 3 |
| 5 | 데이터·모델 오염(Data and Model Poisoning) | 학습·미세조정·검색·기억 데이터를 오염시켜 뒷문과 편향을 심는다 | 4 |
| 6 | 무제한 자원 소비(Unbounded Consumption) | 추론 자원을 통제하지 않아 서비스 거부·비용 폭탄·모델 복제가 생긴다 | 10 |
| 7 | 잘못된 정보(Misinformation) | 그럴듯한 오답을 사람과 에이전트가 믿고 행동한다 | 9 |
| 8 | 숨은 맥락 노출(Hidden Context Exposure) | 시스템 프롬프트·도구 설명 같은 숨은 맥락이 새어 공격을 돕는다 | 7(옛 이름 시스템 프롬프트 유출) |
| 9 | 벡터·임베딩 약점(Vector and Embedding Weaknesses) | 검색 증강(RAG)의 임베딩과 유사도 검색을 노린다 | 8 |
| 10 | 부적절한 출력 처리(Improper Output Handling) | 모델 출력을 검증 없이 셸·브라우저·데이터베이스에 넘긴다 | 5 |
2025년 판에서 달라진 것
- 과도한 권한 위임이 3위로. OWASP는 이를 "목록에서 가장 중대한 이동"이라고 불렀습니다.
- 무제한 자원 소비가 네 계단 올라 6위. 2026년 판은 에이전트 세션에서 맥락이 쌓이며 한 번 주고받는 데 드는 비용이 100번째에는 처음보다 수백 배로 불어나는 예를 듭니다.
- 부적절한 출력 처리가 5위에서 10위로 가장 많이 내려갔습니다. 다만 범위는 오히려 넓어져, AI 코딩 도구가 대량으로 만들어 내는 안전하지 않은 코드까지 다룹니다.
- 시스템 프롬프트 유출이 숨은 맥락 노출로 이름을 바꿨습니다. 시스템 프롬프트뿐 아니라 도구 설명, 권한 규칙 같은 보이지 않는 맥락 전체로 넓혔습니다.
- 프롬프트 인젝션은 사고 데이터만으로 순위를 매기면 10위 밖으로 떨어진다고 OWASP는 밝혔습니다. OWASP는 이를 막는 장치가 늘어난 효과로 설명하며, 여전히 1위에 두었습니다.
10가지 위협 자세히 보기
1. 프롬프트 인젝션
무엇인가. 사용자가 입력하거나 AI가 읽어 들인 글이 개발자가 정한 지시를 무시하게 만드는 공격입니다. 사용자가 직접 넣는 직접 인젝션과, 웹 페이지·문서·메일·이슈 트래커처럼 AI가 읽는 내용에 숨겨 두는 간접 인젝션이 있습니다. 자세한 원리는 프롬프트 인젝션 해설에 정리했습니다.
왜 생기나. OWASP는 "LLM은 구조적으로 '지시'와 '데이터'를 구분하지 않는다. 둘 다 같은 흐름 위의 토큰이다"라고 설명합니다. SQL 인젝션을 막는 매개변수화 쿼리 같은 깔끔한 해법이 없는 이유입니다.
실제로 있었던 일. 2025년 6월 공개된 EchoLeak(CVE-2025-32711)은 Microsoft 365 Copilot에서 사용자가 아무것도 누르지 않아도 정보가 밖으로 새어 나갈 수 있던 취약점입니다. 심각도 점수(CVSS) 9.3으로 매겨졌습니다.
점검할 것. - 자격 증명과 상태를 바꾸는 권한은 모델이 아니라 애플리케이션 코드가 쥐고 있는가 - 외부에서 읽어 온 내용에 출처 표시를 붙여 지시와 섞이지 않게 하는가 - 보이지 않는 유니코드 문자를 지우는가 - 중요한 동작 앞에 사람의 확인을 두는가
2. 민감 정보 노출
무엇인가. 개인정보, 회사 기밀, 비밀 키가 AI를 통해 새는 문제입니다. OWASP는 새는 길이 최종 답변만이 아니라고 강조합니다. 도구 호출 인자, 추론 흔적, 검색해 온 문서 조각, 임베딩, 응답 시간 같은 부수 정보도 모두 노출 경로입니다.
실제로 있었던 일. OWASP 2026년 판은 2023년 3월 ChatGPT의 Redis 라이브러리 버그로 Plus 구독자 1.2%의 결제 관련 개인정보가 노출된 사고를 예로 듭니다.
점검할 것. - 검색하기 전에 권한을 확인하는가(그 사용자가 볼 수 없는 문서를 애초에 가져오지 않는가) - 시스템 프롬프트에 비밀 키나 내부 정보를 넣지 않는가 - 외부 AI로 보내기 전에 개인정보를 가리는가(GenAI Shield가 이 일을 합니다)
3. 과도한 권한 위임
무엇인가. OWASP의 정의는 "LLM의 예상치 못한, 모호한, 또는 조작된 출력에 반응해 피해를 주는 행동이 실행되게 만드는 취약점"입니다. 원인은 지나친 기능, 지나친 권한, 지나친 자율 세 가지입니다. 메일을 요약만 하면 되는 비서에게 메일 전송 기능까지 주거나, 조회만 하면 되는 도구에 데이터베이스 삭제 권한을 주는 경우입니다.
왜 중요해졌나. OWASP는 이 항목과 프롬프트 인젝션의 관계를 이렇게 정리합니다. "프롬프트 인젝션은 입력 쪽의 침해이고, 지나친 기능·권한·자율은 그 침해가 대화창 밖에서 결과를 낳게 만든다." 모델이 속는 것은 막기 어렵지만, 속았을 때 할 수 있는 일은 줄일 수 있습니다.
실제로 있었던 일. 2025년 5월 Invariant Labs는 GitHub MCP 서버를 쓰는 AI 에이전트가 공개 저장소 이슈에 숨긴 지시에 속아 비공개 저장소의 내용을 공개 PR로 올리게 되는 공격을 발표했습니다. 이들은 "GitHub 혼자서는 서버 쪽 패치로 이 취약점을 해결할 수 없다"고 적었습니다. 권한을 어떻게 주느냐의 문제이기 때문입니다.
점검할 것. - 에이전트가 쓸 수 있는 도구와 기능을 꼭 필요한 것만 남겼는가 - 도구가 공용 고권한 계정이 아니라 그 사용자의 권한으로 실행되는가 - 삭제·전송·결제 같은 동작 앞에 사람의 승인이 있는가 - 권한 판단을 LLM에 맡기지 않고 코드로 하는가(OWASP: "LLM에 기대지 말고 로직에서 권한을 확인하라") - 에이전트가 무엇을 불렀는지 기록하고, 위험한 호출은 실행 전에 막는가(GuardTrail이 이 일을 합니다)
4. 공급망
무엇인가. 외부에서 가져온 모델 파일, 어댑터(LoRA), 패키지, 변환·양자화 도구가 오염되거나 바꿔치기되는 위험입니다. 모델 파일 형식에 따라 불러오는 순간 코드가 실행되기도 합니다. AI가 지어낸 그럴듯한 패키지 이름을 공격자가 먼저 등록해 두는 슬롭스쿼팅(slopsquatting)도 여기에 들어갑니다.
실제로 있었던 일. 2025년 7월 AWS는 Amazon Q Developer VS Code 확장 1.84.0에 악의적인 코드가 들어갔던 사건을 공지했습니다(AWS-2025-015, CVE-2025-8217). 빌드 설정의 GitHub 토큰 권한이 지나치게 넓었던 것이 원인이었고, 들어간 코드는 문법 오류로 실행되지는 않았습니다.
점검할 것.
- 쓰는 모델과 데이터의 출처·버전을 목록(SBOM·AIBOM)으로 관리하는가
- 모델 파일에 서명과 검증을 적용하는가. 다만 OWASP의 말대로 "서명은 무결성과 출처를 증명할 뿐 안전을 증명하지는 않는다"
- latest 같은 바뀌는 태그 대신 고정된 버전을 쓰는가
5. 데이터·모델 오염
무엇인가. 학습·미세조정·검색·기억에 쓰는 데이터를 오염시켜, 특정 조건에서만 이상하게 동작하는 뒷문이나 편향을 심는 공격입니다. OWASP는 이것이 한 번의 실행 오류가 아니라 모델의 "학습 과정"을 노린다고 설명합니다.
얼마나 쉬운가. OWASP 2026년 판이 인용한 연구(Souly 외, 2025)에 따르면 오염 문서 250개만으로 6억~130억 매개변수 모델을 데이터셋 크기와 상관없이 오염시킬 수 있었습니다.
실제로 있었던 일. 2023년 7월 Mithril Security는 공개 모델을 조작해 "달에 처음 착륙한 사람은 유리 가가린"이라고 답하게 만든 뒤 비슷한 이름으로 공개 저장소에 올리는 실험(PoisonGPT)을 발표했습니다. 성능 점수는 원래 모델과 0.1% 차이뿐이라 평가로는 알아채기 어려웠습니다. 2025년 2월에는 문서에 숨긴 지시로 Gemini의 장기 기억에 거짓 정보를 저장하게 만드는 시연도 공개됐습니다.
점검할 것. - 학습·검색 데이터의 출처를 추적하는가 - 기억(memory)에 쓰는 일을 권한이 필요한 작업으로 다루는가 - 안전 정렬을 했다고 뒷문이 사라졌다고 가정하지 않고 따로 시험하는가
6. 무제한 자원 소비
무엇인가. 입력과 출력, 반복 호출을 제한하지 않아 서비스가 멈추거나 비용이 폭증하는 위험입니다. 비싼 호출을 유도해 돈을 태우는 지갑 거부(Denial of Wallet), 질문을 반복해 모델을 복제하는 공격도 포함됩니다. OWASP는 이 위협의 특징을 "비용의 비대칭"이라고 부릅니다. 공격자는 적게 쓰고 서비스는 많이 씁니다.
실제로 있었던 일. 2024년 5월 Sysdig는 훔친 클라우드 자격 증명으로 남의 LLM을 몰래 쓰는 LLMjacking 공격을 보고했습니다. 피해자에게 하루 4만 6천 달러가 넘는 LLM 사용료가 나올 수 있었습니다.
점검할 것. - 요청 수만이 아니라 토큰과 비용 단위로 한도를 두는가 - 어떤 경우에도 넘지 못하는 지출 상한을 걸었는가 - 에이전트의 단계 수·재귀 깊이·실행 시간·실행당 비용에 차단기를 두었는가
7. 잘못된 정보
무엇인가. AI가 그럴듯한 오답을 내는 것(AI 환각)이 핵심이 아닙니다. OWASP는 "핵심 위험은 틀린 출력을 믿고 그대로 행동하는 것"이라고 말합니다. 에이전트가 백업을 "완료"라고 거짓 보고해 나중에 복구가 안 되는 경우처럼, 틀린 답이 틀린 행동이 됩니다.
실제로 있었던 일. 2024년 2월 캐나다 BC주 민사분쟁심판소는 Air Canada 챗봇이 유족 할인 규정을 잘못 안내한 사건에서 항공사에 배상을 명령했습니다. 항공사가 챗봇이 별개의 책임 주체라고 주장하자 심판소는 "놀라운 주장"이라며, 항공사가 "챗봇이 정확하도록 합리적인 주의를 기울이지 않았다"고 판단했습니다. AI가 한 말도 회사가 한 말입니다.
점검할 것. - 행동하기 전에 근거를 확인하는 단계가 있는가(주장 → 확인 → 행동) - 출력에 필수 근거 칸이 있는 구조화된 형식을 쓰는가 - 고객에게 나가는 안내가 실제 규정 문서에 근거하는가(AI 챗봇은 등록한 문서만 근거로 답합니다)
8. 숨은 맥락 노출
무엇인가. 사용자에게 보이지 않는 시스템 지시, 도구와 함수의 설명, 거절 조건, 권한 규칙이 추출되는 위험입니다. OWASP는 "숨은 맥락은 들킬 수 있다고 가정하고 설계하라"고 말합니다.
왜 위험한가. 숨은 맥락 자체보다, 그것이 다른 공격을 쉽게 만든다는 점이 문제입니다. 규칙이 드러나면 더 정교한 프롬프트 인젝션이 가능해지고, 그 안에 든 키는 민감 정보 노출이 되고, 도구 권한이 드러나면 과도한 권한 위임을 노리기 쉬워집니다.
점검할 것. - 시스템 프롬프트에 비밀 키·내부 주소·민감한 규칙을 넣지 않았는가 - 권한 통제를 프롬프트 문장이 아니라 LLM 바깥의 코드로 하는가
9. 벡터·임베딩 약점
무엇인가. RAG처럼 문서를 임베딩으로 바꿔 검색하는 구조를 노리는 위험입니다. OWASP는 네 가지로 요약합니다. "오염은 시스템을 틀리게 만들고, 역변환은 새게 만들고, 방해는 침묵하게 만들고, 접근 통제 실패는 가리지 않게 만든다." 임베딩에서 원래 문장을 상당 부분 되살릴 수 있어서, "임베딩뿐이니 괜찮다"는 생각은 안전하지 않습니다.
실제로 있었던 일. 2025년 12월 공개된 RAGFlow 취약점(CVE-2025-69286)은 공유된 어시스턴트 주소만 얻으면 개인 API 키를 알아낼 수 있던 문제입니다.
점검할 것. - 벡터 검색 쿼리 안에서 사용자·조직 범위를 강제하는가(검색한 뒤 거르는 것으로 끝내지 않는가) - 문서마다 출처를 추적하고, 신뢰 등급이 다른 문서를 섞지 않는가 - 지운 문서의 임베딩도 함께 지우는가
10. 부적절한 출력 처리
무엇인가. 모델이 만든 출력을 검증 없이 셸 명령, 웹 페이지, SQL, 다른 시스템에 넘기는 문제입니다. 결과는 웹 보안에서 익숙한 XSS, SSRF, 권한 상승, 원격 코드 실행입니다. 2026년 판은 터미널이 해석하는 ANSI 제어 문자, 마크다운 이미지를 자동으로 불러오며 정보가 새는 경우도 더했습니다.
실제로 있었던 일. 2023년 4월 공개된 LangChain 취약점(CVE-2023-29374)은 수학 계산 체인이 모델 출력을 파이썬 exec로 실행해, 프롬프트 인젝션이 곧바로 임의 코드 실행이 될 수 있던 문제입니다.
점검할 것. - OWASP의 말대로 "모델을 다른 사용자처럼 대하고" 출력을 신뢰하지 않는가 - 출력이 쓰일 곳에 맞게 인코딩하고, 쿼리는 매개변수화하는가 - 마크다운 이미지·링크 미리보기의 자동 불러오기를 막았는가
위협은 서로 이어진다
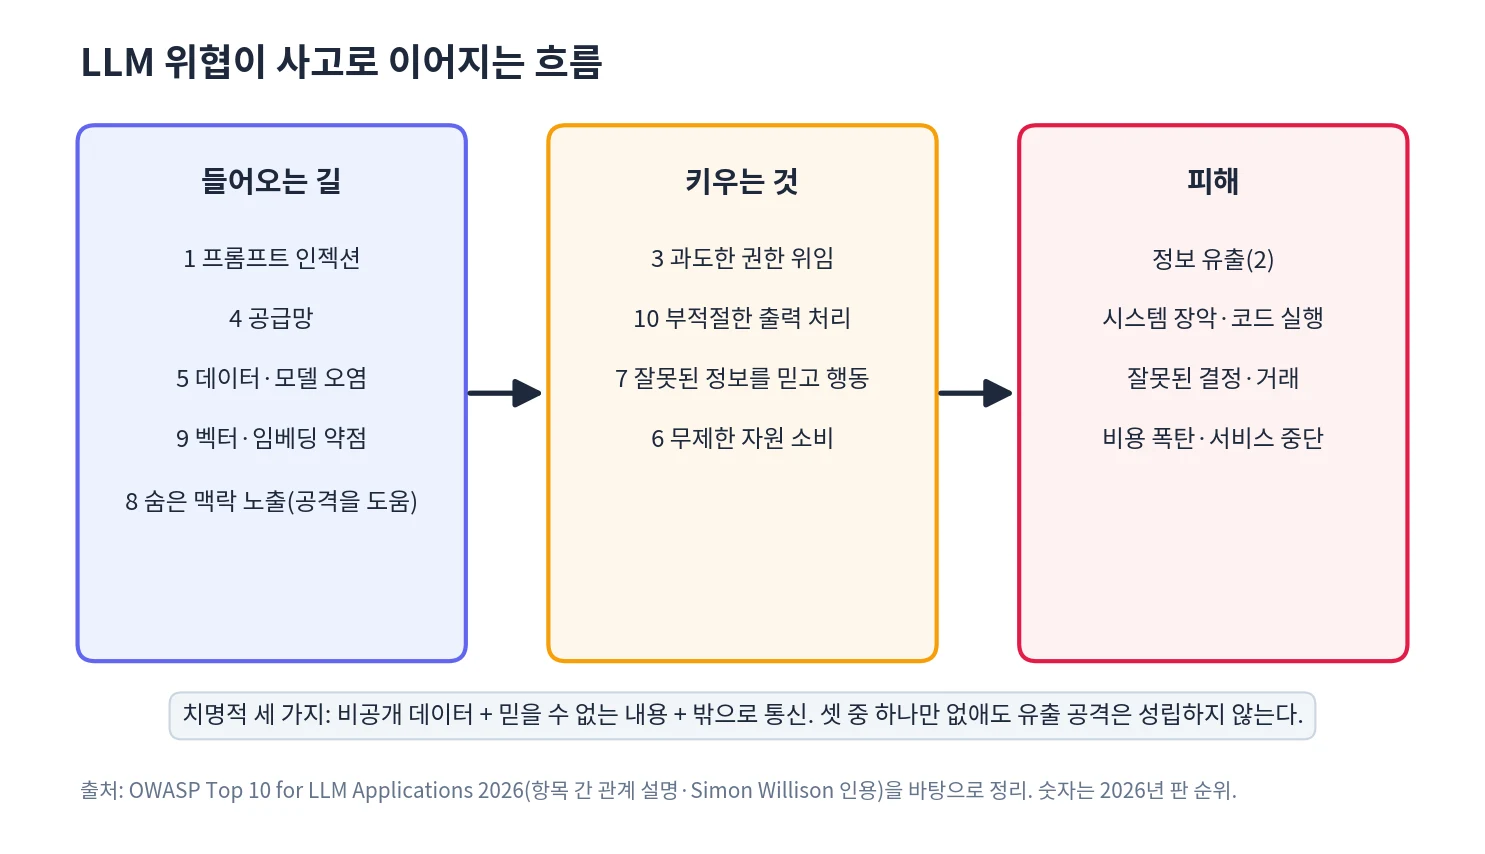
사고는 대개 위협 하나로 끝나지 않습니다. 가장 흔한 흐름은 프롬프트 인젝션으로 모델이 속고, 과도한 권한으로 그 결과가 밖에서 실행되는 것입니다. 숨은 맥락이 새면 공격이 더 정교해지고, 출력을 검증 없이 넘기면 피해가 다른 시스템으로 번집니다.
OWASP 2026년 판은 개발자 Simon Willison이 말한 "치명적 세 가지"를 인용합니다. AI 에이전트가 ① 비공개 데이터에 접근하고, ② 믿을 수 없는 내용을 읽고, ③ 밖으로 통신할 수 있으면 정보 유출이 가능해집니다. 셋 중 하나만 없애도 이 공격은 성립하지 않습니다. 모든 공격을 막으려 하기보다 이 셋이 한 에이전트에 모이지 않게 설계하는 것이 현실적인 방법입니다.
에이전트에는 따로 목록이 있다
OWASP는 2025년 12월 9일 에이전트 애플리케이션을 위한 Top 10도 따로 냈습니다. 목표 탈취, 도구 오용, 신원·권한 남용, 기억·맥락 오염, 에이전트 사이 통신, 연쇄 장애, 통제를 벗어난 에이전트 등을 다룹니다. LLM Top 10 2026년 판은 둘의 경계를 이렇게 설명합니다. 모델이 도구를 부르고 세션 사이에 기억을 가지는 "행위자"가 되는 순간, 위험은 에이전트 Top 10으로 넘어간다는 것입니다.
도입 전 점검표
| 점검 | 관련 위협 |
|---|---|
| 권한 판단과 자격 증명을 모델이 아니라 코드가 쥐고 있는가 | 1, 3, 8 |
| 에이전트가 사용자 본인의 권한으로, 필요한 도구만 쓰는가 | 3 |
| 삭제·전송·결제 앞에 사람의 승인이 있는가 | 3, 7 |
| 외부로 보내기 전에 개인정보를 가리는가 | 2 |
| 검색 전에 권한을 확인하고, 벡터 검색에 사용자 범위를 강제하는가 | 2, 9 |
| 모델·데이터·패키지의 출처와 버전을 관리하는가 | 4, 5 |
| 토큰·비용 한도와 에이전트 차단기가 있는가 | 6 |
| 출력을 신뢰하지 않고 쓰일 곳에 맞게 처리하는가 | 10 |
| 행동 전에 근거를 확인하는가 | 7 |
| 에이전트가 무엇을 불렀는지 기록하고 경보를 받는가 | 1, 3, 6 |
자주 묻는 질문
프롬프트를 잘 쓰면 프롬프트 인젝션을 막을 수 있나요?
부분적으로만 됩니다. OWASP도 시스템 프롬프트로 역할을 제한하는 것을 "부분적 통제"로 봅니다. 모델이 지시와 데이터를 구조적으로 구분하지 못하기 때문입니다. 막는 장치는 프롬프트가 아니라 권한과 구조에 두어야 합니다.
웹 보안의 OWASP Top 10과 무엇이 다른가요?
웹 Top 10이 코드와 설정의 약점을 다룬다면, LLM Top 10은 모델이 입력에 따라 행동이 바뀐다는 점에서 생기는 위험을 다룹니다. 다만 뿌리는 같습니다. 웹 Top 10에서 접근 통제 실패가 1위가 된 것처럼, LLM에서도 결국 "누가 무엇을 할 수 있게 했는가"가 사고의 크기를 정합니다. 두 목록을 함께 보는 것이 좋습니다.
작은 회사도 이걸 다 챙겨야 하나요?
모두를 한 번에 할 필요는 없습니다. 먼저 AI가 무엇에 접근하고 무엇을 할 수 있는지 목록으로 적고, 그 권한을 줄이는 것부터 시작하면 됩니다. 도입 전 점검표의 앞 세 줄이 가장 효과가 큽니다.
정리
LLM Top 10 2026년 판은 한 가지 방향을 분명히 합니다. 모델이 속는 것은 막기 어렵습니다. 대신 속았을 때 할 수 있는 일을 줄이고, 그 사실을 바로 알 수 있게 만들어야 합니다. 보안 사고의 크기는 공격 기법보다 권한과 경계가 정해 왔고, AI 시대에도 그 원칙은 같습니다.