robots.txt로 AI 크롤러(crawler, 웹 페이지를 돌아다니며 읽어 가는 프로그램)를 설정한다는 것은 AI 학습용 크롤러와 AI 검색용 크롤러를 따로 허용하거나 막는 일입니다. AI 서비스들은 모델 학습용, 검색 색인용, 사용자 요청용 크롤러를 서로 다른 이름으로 나눠 두었습니다. 그래서 학습용 수집은 막고 AI 검색 답변에는 나오게 설정할 수 있고, 이름을 잘못 고르면 그 반대 결과도 생깁니다.
한눈에 보기
- robots.txt는 사이트 최상위 경로(루트,
내사이트주소/robots.txt)에 두는 안내문 파일로, 크롤러에게 어디를 읽어도 되는지 알려 줍니다.- AI 크롤러는 학습용(GPTBot, ClaudeBot), 검색용(OAI-SearchBot, Claude-SearchBot, PerplexityBot), 사용자 요청용(ChatGPT-User 등) 이름이 따로 있어서 학습만 막고 AI 검색 노출은 살릴 수 있습니다.
- 파일을 고친 뒤에는 도구로 결과를 확인하고, 방화벽이나 보안 설정이 따로 막고 있지 않은지도 봅니다.
이런 상황을 떠올려 보세요
작은 온라인 쇼핑몰을 운영하는데, 고객이 ChatGPT에 "국산 원목 도마 파는 곳 추천해 줘"라고 물었을 때 우리 가게는 답변에 한 번도 나오지 않습니다. 알아보니 몇 년 전 외주 업체가 만들어 둔 robots.txt 한 줄이 AI 검색 크롤러를 통째로 막고 있었습니다. 반대로 공들여 쓴 상품 설명과 칼럼이 AI 학습 자료로 쓰이는 것은 원하지 않는데, 어디서 무엇을 막아야 하는지 모르는 경우도 있습니다. 두 경우 모두 사이트에 있는 짧은 텍스트 파일 하나부터 보면 됩니다.
설정하기 전에 먼저 볼 것은 크롤러 이름과, 크롤러가 자기에게 해당하는 규칙을 고르는 방식입니다. 아래 목적별 설정 예시는 해석 프로그램 두 가지로 읽어 결과가 같은지 확인했습니다(방법은 글 끝 심화 절에 있습니다). 전체 점검 순서는 AI 검색 최적화 체크리스트에 있습니다.
robots.txt란 무엇인가?
robots.txt는 사이트 최상위 경로, 곧 루트(root, 사이트 주소 바로 뒤 자리)에 두는 안내문 텍스트 파일입니다. 크롤러는 사이트에 들어오기 전에 이 파일부터 읽고, 어느 페이지를 읽어도 되고 어느 페이지는 들어가지 말아야 하는지 확인합니다.
내 사이트의 robots.txt는 브라우저 주소창에 내사이트주소/robots.txt를 입력하면 바로 볼 수 있습니다. 예를 들어 사이트가 https://www.example.co.kr이면 https://www.example.co.kr/robots.txt를 엽니다. 글자 몇 줄이 나오면 파일이 있는 것이고, "페이지를 찾을 수 없음"이 나오면 파일이 없는 것입니다. 파일이 없으면 크롤러는 모든 페이지를 읽어도 된다고 봅니다1.
건물 입구의 출입 안내판에 비유할 수 있습니다. "관계자 외 출입 금지", "3층은 택배 기사님 출입 가능" 같은 안내판입니다. 예의 바른 방문자는 안내판을 따르지만, 안내판 자체가 문을 잠그지는 않습니다. robots.txt도 마찬가지입니다. robots.txt 표준 문서(RFC 9309, 아래에서 설명)는 이 규칙이 접근 권한을 주거나 막는 보안 장치가 아니라고 적었습니다1. 공개하면 안 되는 자료는 robots.txt가 아니라 로그인이나 접근 제한으로 지켜야 합니다.
파일 안에서 가장 먼저 알아 둘 단어는 세 가지입니다.
- User-agent(사용자 에이전트): 크롤러가 스스로 밝히는 이름표입니다.
User-agent: GPTBot은 "여기부터는 GPTBot에게 하는 말"이라는 뜻입니다.User-agent: *는 따로 이름을 적지 않은 모든 크롤러를 가리킵니다. - Disallow(금지): 들어가지 말라는 경로입니다.
Disallow: /admin/은/admin/으로 시작하는 주소를 읽지 말라는 뜻입니다. - Allow(허용): 들어가도 되는 경로입니다.
Disallow로 넓게 막은 안쪽에서 일부만 열어 줄 때 씁니다.
User-agent 줄과 그 아래 Allow·Disallow 줄을 합친 덩어리를 이 글에서는 "묶음"이라고 부릅니다.
왜 AI 크롤러 설정을 따로 봐야 하나?
예전에는 robots.txt가 주로 구글·네이버 같은 검색엔진을 상대했습니다. 지금은 ChatGPT, Claude, Perplexity 같은 AI 서비스도 저마다 크롤러를 보냅니다. 이 크롤러들은 두 가지 일을 합니다. 하나는 AI 모델을 학습시킬 자료를 모으는 일이고, 다른 하나는 사용자가 질문했을 때 답변에 출처로 보여 줄 페이지를 찾는 일입니다. 앞의 것을 막으면 우리 글이 학습 자료로 쓰이지 않고, 뒤의 것을 막으면 AI 검색 답변에 우리 사이트가 나오지 않습니다.
그래서 "AI 크롤러를 막을까 말까"는 한 번에 정할 문제가 아닙니다. 학습과 검색 노출을 따로 정해야 하고, 그러려면 크롤러 이름표부터 알아야 합니다.
AI 크롤러 이름은 각각 무엇에 쓰이나?
크롤러 이름은 운영사마다 여러 개이고, 용도에 따라 학습용, 검색 색인용, 사용자 요청용으로 나뉩니다. 여기서 "색인(indexing)"은 검색엔진이 나중에 찾아 보여 주려고 페이지 내용을 정리해 등록해 두는 일입니다. 도서관이 책마다 목록 카드를 만들어 꽂아 두는 일과 비슷합니다.
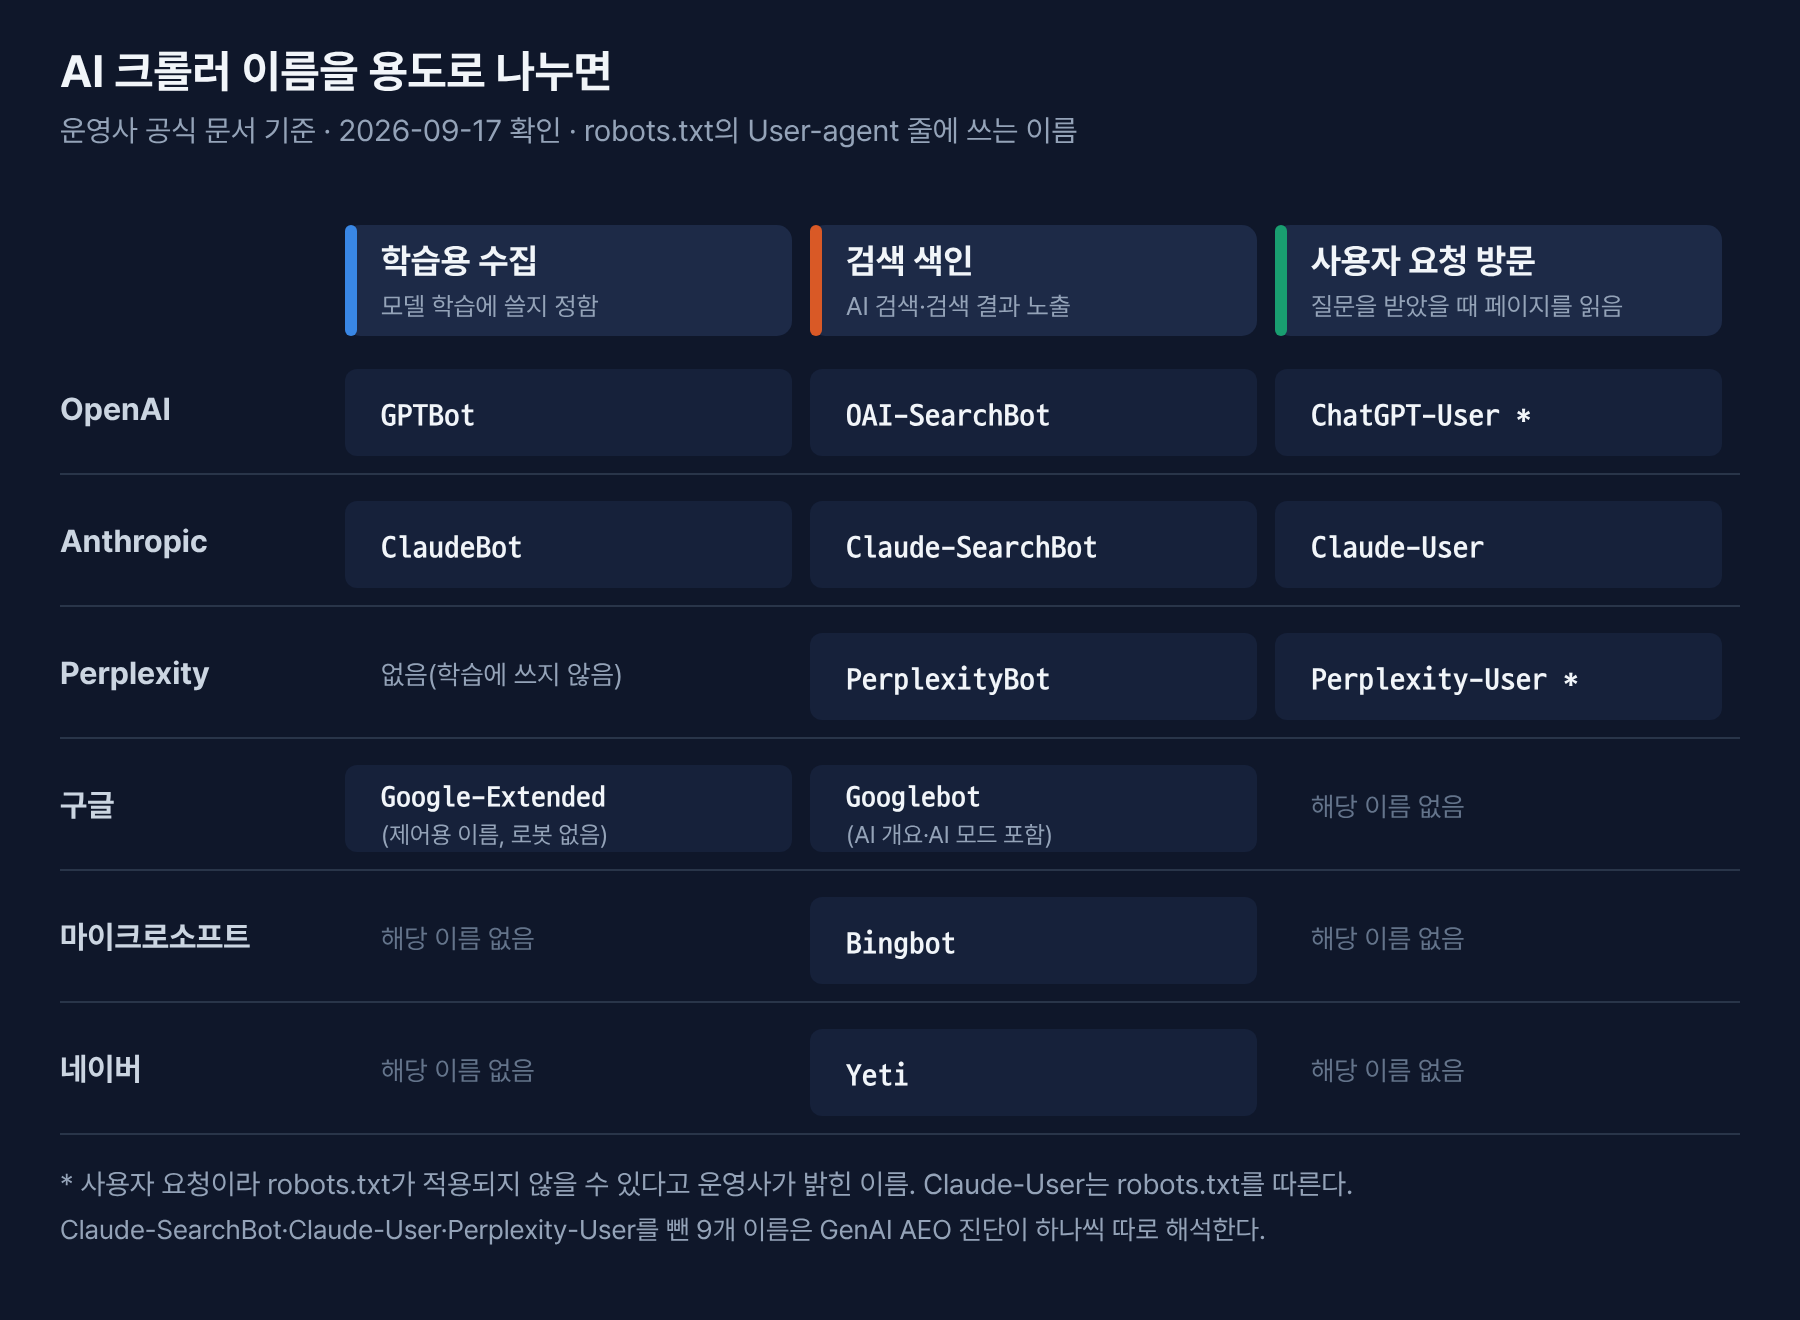
처음 설정할 때는 다음 일곱 이름부터 알아 두면 됩니다.
- GPTBot(OpenAI): 생성형 AI 기반 모델 학습에 쓸 수 있는 내용을 모읍니다. 막으면 학습에 쓰지 말라는 뜻으로 처리합니다3.
- OAI-SearchBot(OpenAI): ChatGPT 검색 결과에 사이트를 보여 주는 데 씁니다. 막으면 검색 답변 본문에는 인용되지 않고, 사이트 이름을 찾는 질문에서 링크로만 나올 수 있습니다3.
- ClaudeBot(Anthropic): 모델 학습에 쓰일 수 있는 웹 내용을 모읍니다4.
- Claude-SearchBot(Anthropic): 검색 결과 품질을 높이려고 페이지를 색인합니다4.
- PerplexityBot(Perplexity): Perplexity 검색 결과에 사이트를 보여 주고 링크를 거는 데 씁니다. 기반 모델 학습에는 쓰지 않는다고 밝혔습니다6.
- Google-Extended(구글): 요청을 보내는 크롤러가 아니라, 구글이 수집한 내용을 Gemini 학습과 답변 근거(grounding)로 쓸지 정하는 이름입니다5.
- Yeti(네이버): 네이버 검색 크롤러입니다2.
사용자 요청용 이름까지 모든 이름의 용도와 robots.txt 적용 방식은 글 끝 '개발자를 위한 심화' 절의 표에 모았습니다.
학습용과 검색용은 이름이 달라 따로 설정할 수 있습니다. OpenAI는 두 설정이 서로 독립이라고 명시했습니다3. 구글에는 AI 개요와 AI 모드를 따로 제어하는 크롤러 이름이 없습니다. 구글 검색의 AI 기능은 Googlebot이 수집한 색인을 쓰므로, 노출 범위는 nosnippet, max-snippet, noindex 같은 기존 검색 제어 표시로 관리합니다7. 이 표시들은 페이지 안에 적어 두며, 검색 결과에 스니펫(snippet, 제목 아래 함께 보이는 본문 발췌)을 얼마나 보여 줄지와 검색에 올릴지를 정합니다. Google-Extended를 막아도 구글 검색과 AI 개요 노출은 달라지지 않습니다5. 사용자 요청형 방문은 운영사마다 robots.txt를 대하는 방식이 다르니 심화 절 표의 오른쪽 칸을 따로 확인하세요.
목적별 설정 예시
User-agent 줄을 여러 개 이어 쓰면 한 묶음을 여러 크롤러가 함께 씁니다. 아래 표기에서 O는 허용, X는 차단입니다. 아래 코드 상자는 robots.txt 파일에 그대로 적는 내용이고, Sitemap 줄은 사이트맵(sitemap, 사이트의 페이지 목록 파일)이 어디 있는지 알려 주는 줄입니다.
설정 1. AI 검색과 학습 모두 허용
관리 화면처럼 누구에게도 보일 필요가 없는 경로만 막습니다. 규칙에 걸리지 않는 경로는 허용이므로 Allow: /는 적지 않습니다.
아래는 모든 크롤러에 대해 관리 화면과 로그인 화면만 막는 robots.txt입니다.
User-agent: *
Disallow: /admin/
Disallow: /login

Sitemap: https://www.example.co.kr/sitemap.xml
설정 2. 학습용 수집만 거부하고 검색 노출은 유지
아래는 학습용 이름 세 개만 사이트 전체에서 막고, 나머지 크롤러는 설정 1과 같이 두는 robots.txt입니다.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /admin/
Disallow: /login

Sitemap: https://www.example.co.kr/sitemap.xml
| 경로 | GPTBot·ClaudeBot·Google-Extended | OAI-SearchBot·Claude-SearchBot·PerplexityBot·Googlebot·Yeti |
|---|---|---|
/ |
X | O |
/blog/post-1 |
X | O |
/admin/users |
X | X |
회사의 콘텐츠 방침이 "학습에는 쓰지 말되 답변의 출처로는 인용되어도 좋다"일 때 쓰는 형태입니다. PerplexityBot은 학습에 쓰지 않는다고 밝혔으므로 이 목적이라면 막을 이유가 없습니다6.
설정 3. 학습용 크롤러에게 일부 경로만 허용
공개 블로그만 학습에 써도 되고 나머지는 안 된다는 방침이라면 이렇게 씁니다. /blog/가 /보다 긴 규칙이라 블로그 경로에서는 Allow가 우선합니다.
아래는 학습용 크롤러 두 개에게 /blog/ 아래만 열어 주는 robots.txt입니다. 구글 학습까지 같은 방침으로 두려면 같은 묶음에 User-agent: Google-Extended 줄을 더하면 됩니다.
User-agent: GPTBot
User-agent: ClaudeBot
Allow: /blog/
Disallow: /

User-agent: *
Disallow: /admin/
Disallow: /login

Sitemap: https://www.example.co.kr/sitemap.xml
| 경로 | GPTBot·ClaudeBot | 그 밖의 크롤러 |
|---|---|---|
/ |
X | O |
/blog/post-1 |
O | O |
/admin/users |
X | X |
Allow: /blog/를 Disallow: /보다 먼저 적었습니다. 표준을 따르는 파서(parser, robots.txt를 읽어 규칙으로 해석하는 프로그램)는 순서와 상관없이 긴 규칙을 고르지만, 위에서부터 차례로 읽다가 처음 맞는 규칙을 따르는 파서도 있습니다. 긴 규칙을 앞에 두면 어느 쪽으로 읽어도 같은 결과가 나옵니다.
설정 4. AI 서비스 크롤러는 모두 막고 일반 검색엔진만 허용
아래는 AI 서비스 크롤러 이름을 사이트 전체에서 막는 robots.txt입니다.
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /admin/
Disallow: /login

Sitemap: https://www.example.co.kr/sitemap.xml
이 설정을 쓰면 다음과 같은 결과가 따릅니다. ChatGPT 검색, Claude, Perplexity 답변에서 사이트가 출처로 쓰이기 어려워집니다. 구글 AI 개요와 AI 모드는 Googlebot 색인을 쓰므로 이 설정으로 빠지지 않습니다. ChatGPT-User와 Perplexity-User는 사용자 요청이라 robots.txt가 적용되지 않을 수 있습니다36. 이 둘까지 막아야 한다면 방화벽(firewall, 서버 앞에서 들어오는 요청을 걸러 내는 장치)에서 운영사가 공개한 IP 목록(크롤러가 접속할 때 쓰는 인터넷 주소 번호 목록)으로 막는 방법을 검토합니다. AI 검색 노출을 포기하는 결정이므로 회사 안에서 먼저 합의해 두는 것이 좋습니다.
크롤러는 규칙을 어떻게 고르나?
위 예시가 왜 그렇게 동작하는지는 세 가지 규칙으로 설명됩니다. robots.txt는 2022년 9월 IETF(Internet Engineering Task Force, 인터넷 기술 표준을 정하는 국제 단체)의 표준 문서 RFC 9309로 정리됐습니다1. RFC(Request for Comments)는 그 단체가 내는 표준 문서에 붙는 이름과 번호입니다. 네이버 서치어드바이저도 이 문서를 기준으로 안내합니다2.
- 묶음 고르기. 크롤러는
User-agent줄에서 자기 이름(대소문자 구분 없음)을 찾습니다. 있으면 그 묶음만 따르고, 같은 이름의 묶음이 여러 개면 규칙을 합쳐 하나로 읽습니다. 자기 이름 묶음이 없을 때만User-agent: *묶음을 따릅니다. 이름 묶음이 있는 크롤러는*묶음의 규칙을 함께 적용하지 않습니다1. - 규칙 고르기. 요청할 경로에 맞는
Allow와Disallow가운데 경로가 가장 긴(가장 구체적인) 규칙이 우선합니다. 길이가 같으면Allow를 따릅니다. 맞는 규칙이 없으면 허용입니다1. - 묶음 밖 규칙.
User-agent줄보다 앞에 있는 규칙처럼 어느 묶음에도 속하지 않은Allow·Disallow는 무시하라고 표준이 권합니다1.
첫 번째 규칙은 안내판에 비유하면 이렇습니다. "택배 기사님은 3층만"이라는 안내판이 따로 있으면 택배 기사는 그 안내판만 보고, 모두에게 붙은 "지하 출입 금지" 안내판은 보지 않습니다. 그래서 이름 묶음을 만들 때는 공통으로 막을 경로를 거기에도 다시 적어야 합니다.
robots.txt는 주소 앞부분(https인지 http인지, www가 붙었는지)이 똑같은 사이트에만 적용됩니다. www가 붙은 주소와 붙지 않은 주소, http와 https를 서로 다른 사이트로 본다는 뜻입니다. 네이버 안내에 따르면 https://www.example.co.kr/robots.txt의 내용은 https://example.co.kr/에 적용되지 않습니다2. 두 주소를 모두 쓴다면 양쪽 robots.txt를 같게 두거나 한쪽으로 리다이렉트(redirect, 한 주소로 들어온 방문자를 다른 주소로 자동으로 넘기는 설정)합니다.
응답 코드에 따른 처리, 캐시와 파일 크기처럼 더 자세한 동작은 글 끝의 '개발자를 위한 심화' 절에 모았습니다.
자주 하는 실수 다섯 가지
규칙을 묶음 밖에 쓰기
파일 맨 위나 Sitemap 줄 아래에 User-agent 없이 Disallow를 적으면 어느 크롤러에도 적용되지 않습니다. GenAI AEO 진단의 "robots.txt 규칙 묶음" 항목이 이것을 봅니다. 국내외 주요 사이트에서 이 항목을 얼마나 통과했는지는 국내 주요 사이트 103곳 첫 관측에 있습니다.
묶음 안에 빈 줄과 주석 섞기
RFC 9309 문법은 묶음 안의 빈 줄을 허용합니다1. 그런데 파이썬 표준 라이브러리의 urllib.robotparser처럼 빈 줄을 묶음의 끝으로 읽는 파서가 있습니다. 이런 파서로 읽으면 빈 줄 아래 규칙은 묶음 밖 규칙이 되어 사라집니다. 사람 눈에는 한 덩어리로 보여도 프로그램에 따라 두 덩어리로 읽힐 수 있다는 뜻입니다.
젠아이랩스(GenAI Labs)도 이 실수를 했습니다. 2026년 9월 12일 gensapps.com의 robots.txt는 아래와 비슷한 모양이었습니다. #로 시작하는 줄은 사람이 읽으라고 단 메모, 곧 주석(comment)입니다.
User-agent: *
Allow: /

# Static files
Allow: /static/

# Crawl delay (seconds) - prevent server overload
Crawl-delay: 10

# Exclude SaaS service pages (managed separately)
Disallow: /saas/
Disallow: /console/
주석을 달아 보기 좋게 나눈 빈 줄 때문에 urllib.robotparser로 읽으면 Disallow 규칙이 모두 무효였습니다. Crawl-delay: 10도 AI 크롤러에게 요청 사이 10초를 요구하는 값이었습니다. 같은 날 규칙을 빈 줄 없이 붙이고 Crawl-delay를 뺐으며, 파일 맨 위 주석에 그 이유를 적었습니다.
이름 묶음을 만들고 공통 차단을 옮겨 적지 않기
학습용 크롤러에게 일부 경로를 허용하려고 이름 묶음을 만들면, 그 크롤러는 * 묶음의 Disallow: /admin/을 더는 보지 않습니다. 이름 묶음에도 공통 차단 경로를 다시 적어야 합니다. 같은 줄을 되풀이해 적기가 번거롭고 틀리기 쉬워서 gensapps.com은 AI 크롤러 전용 묶음을 두지 않고 * 묶음 하나로 운영합니다.
Allow: /를 맨 앞에 두기
RFC 9309 파서에서는 Allow: / 뒤에 Disallow: /admin/을 써도 긴 규칙인 Disallow가 이깁니다. 하지만 위에서부터 처음 맞는 규칙을 따르는 파서는 Allow: /에서 멈춰 /admin/까지 허용으로 읽습니다. 실제로 파이썬 urllib.robotparser로 확인하면 그렇게 나옵니다. Allow: /는 적지 않아도 결과가 같으니 빼는 편이 안전합니다.
Crawl-delay를 크게 두기
Crawl-delay는 크롤러에게 페이지를 하나 가져간 뒤 다음 페이지까지 몇 초 쉬라고 요청하는 줄입니다. RFC 9309에 없는 확장 지시어라서 따르는 곳도 있고 무시하는 곳도 있습니다. Anthropic은 지원한다고 밝혔고4, 구글은 따르지 않는다고 적었습니다. 지원하는 크롤러에게 10초를 요구하면 정해진 시간 안에 가져갈 수 있는 페이지 수가 크게 줄어듭니다. GenAI AEO 진단은 AI 크롤러에 1초를 넘는 값이 걸려 있으면 기준 미달로 봅니다. 서버 부하가 걱정이면 Crawl-delay보다 CDN(Content Delivery Network, 사이트 파일을 여러 곳에 복사해 두고 가까운 곳에서 대신 내주는 서비스) 캐시나 요청 속도 제한 설정으로 다루는 편이 낫습니다.
robots.txt에서 허용했는데 왜 막히나?
robots.txt에서 허용해도 방화벽, CDN의 봇 관리 기능(bot management, 사람이 아닌 프로그램의 접속을 가려내 막거나 늦추는 기능), 호스팅 업체의 보안 설정이 요청을 403으로 거절할 수 있습니다. 403은 서버가 "접근 금지(Forbidden)"라고 돌려주는 응답 코드(서버가 요청 결과를 알려 주는 세 자리 번호)입니다. 안내판에는 들어와도 된다고 적혀 있는데 입구의 경비원이 돌려보내는 것과 같습니다. 구글은 AI 기능에 나타나려면 robots.txt와 함께 CDN·호스팅 설정에서도 수집이 허용되어 있어야 한다고 적었습니다7.
젠아이랩스가 2026년 9월 17일 국내외 주요 사이트를 잰 결과에서도, 해외 대형 사이트는 robots.txt보다 봇 관리 기능의 403으로 막는 쪽이 훨씬 흔했습니다. 이 관측은 젠아이랩스 관측 크롤러 기준이라 AI 서비스의 크롤러까지 막혔다고 단정할 수는 없습니다. 다만 담당자가 모르는 사이에 같은 장치가 AI 크롤러도 거절하고 있을 수 있습니다. 수치와 결과 전체는 국내 주요 사이트 103곳 첫 관측에 있습니다.
봇 차단 설정에서 AI 크롤러를 허용할 때는 사용자 에이전트 이름만 믿지 않습니다. 이름은 누구나 흉내 낼 수 있기 때문입니다. OpenAI와 Perplexity는 크롤러별 IP 목록을 공개하고 있고36, Anthropic은 IP 차단 대신 robots.txt로 거부하라고 권합니다4.
어디서 고치고 어떻게 확인하나?
robots.txt는 어디서 고치나?
robots.txt는 사이트 최상위 경로(루트)에 있어야 합니다10. 직접 서버를 운영한다면 그 폴더의 파일을 고치면 되지만, 쇼핑몰 솔루션이나 홈페이지 제작 서비스를 쓴다면 파일을 직접 열 수 없는 경우가 많습니다. 구글도 호스팅 서비스를 쓰면 robots.txt를 직접 수정하지 못할 수 있으니, 그 서비스의 검색 설정 안내를 찾아보라고 안내합니다10. 서비스에 따라 관리자 화면의 검색엔진 최적화(SEO) 설정에 robots.txt 입력 칸을 두는 곳도 있습니다. 메뉴를 찾기 어렵다면 호스팅 업체 고객센터나 사이트를 만든 개발 담당자에게 요청합니다.
마케터가 할 일, 개발 담당자에게 요청할 일
마케터가 먼저 방침을 정하고, 파일 수정과 서버 설정은 개발 담당자나 호스팅 업체에 맡깁니다.
마케터나 운영 담당자가 직접 할 일
- 브라우저에서
내사이트주소/robots.txt를 열어 지금 내용을 확인하고 복사해 둡니다. - 회사 방침을 정합니다. 학습 수집을 허용할지, AI 검색 노출을 원하는지 두 질문에 따로 답합니다.
- 방침에 맞는 설정 예시(위 설정 1~4)를 고릅니다.
- 개발 담당자가 파일을 고친 뒤, 네이버 서치어드바이저(네이버가 제공하는 사이트 관리 도구)의 robots.txt 도구로 Yeti 기준 수집 가능 여부를 테스트하고 수집 요청을 보냅니다2.
- 고친 뒤 하루쯤 지나 다시 확인합니다. OpenAI와 Perplexity는 변경이 반영되기까지 24시간쯤 걸릴 수 있다고 안내합니다36.
개발 담당자나 호스팅 업체에 요청할 일
- 고른 설정 예시를 전달하고 robots.txt 반영을 요청합니다.
www가 있는 주소와 없는 주소를 모두 쓴다면 양쪽에 같은 내용이 들어가는지도 묻습니다. - 방화벽, CDN 봇 관리, 호스팅 보안 설정이 허용하려는 AI 크롤러를 403으로 막고 있지 않은지 확인해 달라고 합니다.
- 서버 접속 기록에서 크롤러 이름별 응답 코드를 봐 달라고 합니다. robots.txt에서 허용한 이름이 403을 받고 있다면 봇 차단 설정을 고쳐야 합니다.
- 아래 '개발자를 위한 심화' 절의 스크립트로 두 파서의 해석이 같은지 확인해 달라고 합니다.
우리 사이트는 어떤가?
위 순서를 하나하나 따라가기 어렵다면 사이트 주소만 넣어 확인하는 방법도 있습니다. 젠아이랩스의 GenAI AEO 진단은 OAI-SearchBot, GPTBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended, Googlebot, Bingbot, Yeti 아홉 이름을 하나씩 해석해 막힌 이름, 묶음 밖 규칙, 1초를 넘는 Crawl-delay, 사이트맵 위치 표기 여부를 함께 보여 줍니다(진단 기준 2026.09.15-2 판)9. 크롤러 접근 항목은 무료 진단 18개 항목에 들어 있습니다(전체 19개 항목 가운데 자바스크립트 실행 전후 비교 1개는 무료 진단에서 뺍니다). 이 아홉 이름에 Claude-SearchBot은 없으니, 그 이름은 위 설정 예시와 대조해 직접 확인하세요. GenAI AEO 무료 진단 시작하기
robots.txt 다음에 볼 항목은 AI 검색 최적화 체크리스트에 순서대로 있습니다. 함께 읽기: llms.txt란? · 생성형 AI 검색 최적화(GEO)란? · 국내 주요 사이트 103곳 첫 관측
개발자를 위한 심화
이 부분은 직접 구현하는 개발자를 위한 내용입니다.
AI 크롤러 이름 전체 표
운영사가 공식 문서에 적은 이름과 용도만 모았습니다. "robots.txt 적용"은 운영사가 문서에 적은 표현을 따른 것입니다.
| 이름(User-agent) | 운영사 | 용도 | robots.txt 적용 |
|---|---|---|---|
| GPTBot | OpenAI | 생성형 AI 기반 모델 학습에 쓸 수 있는 내용 수집 | 따름. 막으면 학습에 쓰지 말라는 뜻으로 처리3 |
| OAI-SearchBot | OpenAI | ChatGPT 검색 결과에 사이트 노출 | 따름. 막으면 검색 답변 본문에는 인용되지 않고, 사이트 이름을 찾는 질문에서 링크로만 나올 수 있음3 |
| ChatGPT-User | OpenAI | 사용자가 ChatGPT에 질문했을 때 페이지 방문 | 사용자 요청이라 적용되지 않을 수 있음3 |
| OAI-AdsBot | OpenAI | ChatGPT 광고로 제출된 웹 페이지의 안전성 확인. 모은 내용은 기반 모델 학습에 쓰지 않음 | 문서에 따로 적혀 있지 않음3 |
| ClaudeBot | Anthropic | 모델 학습에 쓰일 수 있는 웹 내용 수집 | 따름4 |
| Claude-SearchBot | Anthropic | 검색 결과 품질 향상을 위한 색인 | 따름4 |
| Claude-User | Anthropic | 사용자가 Claude에 질문했을 때 페이지 방문 | 따름. 막으면 사용자 요청으로도 가져가지 않음4 |
| PerplexityBot | Perplexity | 검색 결과에 사이트 노출과 링크. 기반 모델 학습에는 쓰지 않음 | 따름6 |
| Perplexity-User | Perplexity | 사용자 질문에 답하려고 페이지 방문 | 사용자 요청이라 대체로 무시6 |
| Google-Extended | 구글 | 요청을 보내는 크롤러는 없음. 수집한 내용을 Gemini 학습과 답변 근거(grounding)로 쓸지 정하는 이름 | robots.txt에만 쓰는 제어용 이름. 구글 검색 노출에는 영향 없음5 |
| Googlebot | 구글 | 구글 검색 색인. AI 개요·AI 모드도 여기서 수집한 색인을 씀 | 따름57 |
| Bingbot | 마이크로소프트 | Bing의 기본 크롤러 | 따름8 |
| Yeti | 네이버 | 네이버 검색 수집 | 따름2 |
robots.txt는 어떤 순서로 읽히나?
크롤러가 robots.txt를 받아 규칙을 적용하기까지의 순서는 다음과 같습니다. 앞의 "크롤러는 규칙을 어떻게 고르나?"에서 설명한 묶음·규칙 고르기에 응답 코드별 처리가 더해집니다.
flowchart TD
    A["robots.txt 요청"] --> B{"응답 코드"}
    B -- "2xx" --> C["규칙 읽기"]
    B -- "4xx" --> D["모두 허용으로 봄"]
    B -- "5xx · 연결 실패" --> E["모두 막힌 것으로 봄"]
    C --> F{"내 이름의 묶음이 있나"}
    F -- "있음" --> G["그 묶음만 적용
같은 이름 묶음이 여럿이면 합침"]
    F -- "없음" --> H["User-agent: * 묶음 적용"]
    G --> I["경로에 맞는 규칙 중
가장 긴 규칙이 이김"]
    H --> I
- 응답 코드. robots.txt가 404 같은 4xx면 크롤러는 모든 경로를 가져가도 됩니다. 500 같은 5xx나 네트워크 오류면 사이트 전체를 막힌 것으로 봅니다1. 네이버도 같은 방식으로 처리하고, 리다이렉트는 5회까지 따라간다고 밝혔습니다2. 서버 장애로 robots.txt가 5xx를 내면 그동안 크롤러가 사이트 전체를 건너뛸 수 있다는 뜻입니다.
- 캐시와 크기. 크롤러는 받은 robots.txt를 캐시할 수 있지만 24시간을 넘겨 쓰지 않는 것이 원칙이고, 파일은 최소 500KiB까지 읽습니다1. OpenAI와 Perplexity는 robots.txt 변경이 반영되기까지 24시간쯤 걸릴 수 있다고 안내합니다36.
파이썬으로 이름별 결과 뽑아 보기
아래 파이썬 코드는 사이트의 robots.txt를 내려받아 두 파서로 읽고, 크롤러 11개와 경로 3개의 허용 여부를 표 형태로 출력합니다. protego는 RFC 9309를 따르는 파서이고(pip install protego), urllib.robotparser는 파이썬에 들어 있는 파서입니다. 두 결과가 다르면 파일 구조를 고칠 곳이 있다는 신호입니다.
import urllib.robotparser
import urllib.request
from protego import Protego

SITE = "https://www.example.co.kr"
BOTS = ["GPTBot", "OAI-SearchBot", "ChatGPT-User", "ClaudeBot", "Claude-SearchBot",
        "Claude-User", "PerplexityBot", "Google-Extended", "Googlebot", "Bingbot", "Yeti"]
PATHS = ["/", "/blog/", "/admin/"]

text = urllib.request.urlopen(SITE + "/robots.txt").read().decode("utf-8", "replace")
rfc = Protego.parse(text)
old = urllib.robotparser.RobotFileParser()
old.parse(text.splitlines())

for bot in BOTS:
    row = []
    for path in PATHS:
        a = rfc.can_fetch(SITE + path, bot)
        b = old.can_fetch(bot, path)
        mark = ("O" if a else "X") + ("" if a == b else "(파서마다 다름)")
        row.append(f"{path} {mark}")
    print(f"{bot:17}", "  ".join(row))
참고 자료
| 번호 | 자료 | 다루는 내용 | 발행처·날짜(확인일) |
|---|---|---|---|
| 1 | RFC 9309 Robots Exclusion Protocol | 묶음 선택·병합, 가장 긴 규칙, 응답 코드별 처리, 캐시, 보안 장치가 아니라는 점 | IETF, 2022-09(2026-09-17) |
| 2 | robots.txt 설정하기 | Yeti, 응답 코드별 처리, 호스트별 적용, robots.txt 도구 | 네이버 서치어드바이저(2026-09-17) |
| 3 | Overview of OpenAI Crawlers | GPTBot, OAI-SearchBot, ChatGPT-User, OAI-AdsBot, IP 목록, 반영 시간 | OpenAI(2026-09-17, OAI-AdsBot은 2026-09-27) |
| 4 | Does Anthropic crawl data from the web | ClaudeBot, Claude-SearchBot, Claude-User, Crawl-delay | Anthropic(2026-09-17) |
| 5 | Google's common crawlers | Googlebot, Google-Extended | Google, 2026-07-14 갱신(2026-09-17) |
| 6 | Perplexity Crawlers | PerplexityBot, Perplexity-User, IP 목록, 반영 시간 | Perplexity(2026-09-17) |
| 7 | AI features and your website | AI 기능의 수집 제어, 스니펫 제어, CDN·호스팅 허용 | Google Search Central, 2025-12-10 갱신(2026-09-17) |
| 8 | Overview of Bing crawlers | Bingbot | Microsoft Bing Webmaster Tools(2026-09-17) |
| 9 | GenAI AEO 진단 기준 | AI 크롤러 접근 영역 항목과 기준값 | GenAI Labs, 기준 2026.09.15-2 판(2026-09-17) |
| 10 | robots.txt 파일 작성 및 제출 방법 | 파일 위치(사이트 최상위), 호스팅 서비스에서 직접 수정하지 못하는 경우 | Google Search Central, 2025-11-26 갱신(2026-09-27) |
글쓴이 박수현(젠아이랩스 대표) with AI (Claude Opus 5). 본문의 gensapps.com robots.txt 사례는 GenAI Labs 사이트 점검 기록에서 가져왔습니다. 『바이브 코딩의 시대, 프롬프트를 넘어 컨텍스트 엔지니어링으로』를 비롯해 AI 실무서 네 권을 썼습니다.