트랜스포머(Transformer)는 문장 속 단어들이 서로를 참고해 뜻을 정하도록 계산하는 신경망 구조입니다. 신경망은 숫자를 주고받는 작은 계산 단위를 여러 층으로 엮어, 수많은 예시를 보며 스스로 규칙을 맞춰 가는 프로그램을 말합니다. 지금 우리가 쓰는 거의 모든 대규모 언어 모델(LLM, 방대한 글을 읽고 배워 문장을 이어 쓰는 AI 모델)이 이 구조 위에 서 있습니다.
한눈에 보기
- 트랜스포머는 문장 속 단어들이 서로를 참고해 뜻을 정하게 하는 계산 방식이며, ChatGPT 같은 대화형 AI의 뼈대입니다.
- 핵심은 '어텐션'으로, 단어마다 문장의 어느 부분을 얼마나 참고할지 점수를 매겨 문맥을 파악합니다.
- 문장을 한꺼번에 처리해 빠르게 대량 학습할 수 있지만, 글이 길어질수록 계산 비용이 가파르게 늘어나는 약점도 있습니다.
한 문장으로 붙잡는 트랜스포머의 정체
이런 상황을 떠올려 보세요. 작은 온라인 쇼핑몰을 운영하는데 고객 문의가 하나 들어옵니다. "지난주에 주문한 니트 아직 안 왔는데요, 그거 취소하고 다른 색으로 다시 받을 수 있을까요? 아 그리고 사이즈는 그대로요." 사람은 '그거'가 니트 주문이고 '다른 색'과 '사이즈'가 모두 그 니트 이야기라는 것을 단번에 압니다. 그런데 예전 방식처럼 컴퓨터가 앞에서부터 한 단어씩 읽어 가며 그 내용을 메모 한 장에 덮어써 간다면, 문장이 길어질수록 앞에 나온 '니트'를 잊기 쉽습니다. 그러면 뒤에 나온 '그거'와 '사이즈'가 무엇의 이야기인지 흐려집니다. 요즘은 이 문의를 ChatGPT에 붙여 넣고 답장 초안을 부탁하면 제법 정확하게 알아듣습니다. 문장 안의 단어들이 서로를 되짚어 보며 뜻을 맞추게 하는 장치, 그것이 이 글에서 풀어 볼 트랜스포머입니다.
조금 더 정확히 말하면, 트랜스포머는 문장 속 모든 토큰(token, AI가 글을 읽고 쓰는 조각 단위로, 보통 단어 하나보다 조금 작은 단위)이 서로에게 얼마나 주목할지를 계산하는 '자기어텐션(self-attention)'을 핵심으로 삼습니다. 앞에서부터 한 단어씩 읽지 않고 문장 전체를 한꺼번에 읽어 냅니다.
이 구조는 2017년 구글 연구진이 발표한 논문 「Attention Is All You Need」에서 처음 제안됐습니다. ChatGPT의 GPT, 구글의 BERT, 그 밖의 수많은 모델이 모두 트랜스포머의 후손입니다.
이름부터 특이합니다. 전기 기기인 변압기(transformer)와는 아무 상관이 없습니다. 여기서 '변환'은 입력 토큰의 표현을 층층이 거치며 점점 더 문맥이 반영된 표현으로 바꿔 나간다는 뜻에 가깝습니다. 예를 들어 '고양이'라는 토큰이 처음에는 단어 자체의 의미만 담고 있다가, 층을 지날수록 '앞에 나온 문장에서의 고양이'라는 맥락까지 흡수한 표현으로 다듬어집니다.
트랜스포머를 제대로 이해하려면 먼저 한 가지 관점을 받아들여야 합니다. 언어 모델이 하는 일은 결국 '지금까지의 문장을 보고 다음 토큰으로 가장 그럴듯한 것을 하나 고르기'의 반복입니다. 트랜스포머는 바로 이 '고르기'를 계산하는 엔진입니다. 문장을 토큰으로 쪼개고, 각 토큰을 의미의 좌표로 바꾸고, 토큰끼리 서로 주목하게 한 뒤, 다음 토큰의 확률 분포를 뽑아냅니다.
순환 신경망의 병목: 왜 새 구조가 필요했나
트랜스포머 이전, 기계 번역이나 문장 생성 같은 작업의 주역은 순환 신경망(RNN)과 그 개량형인 LSTM이었습니다. 순환 신경망은 문장을 한 단어씩 읽으면서 지금까지 읽은 내용을 메모 한 장에 덮어써 가는 방식이고, LSTM은 그 메모에서 무엇을 오래 남기고 무엇을 지울지 조절하는 장치를 더한 개량형입니다. 「Sequence to Sequence Learning with Neural Networks」로 대표되는 이 계열은 문장을 왼쪽에서 오른쪽으로 한 단어씩 순서대로 읽었습니다. 첫 단어를 처리해 상태를 만들고, 그 상태에 둘째 단어를 얹고, 다시 셋째 단어를 얹는 식입니다. 사람이 글을 읽는 방식과 닮아 직관적이었습니다.
문제는 두 가지였습니다. 첫째, 순서대로만 계산할 수 있어 병렬화, 곧 여러 계산을 동시에 나눠 돌리기가 어려웠습니다. 다섯째 단어를 처리하려면 넷째까지가 끝나야 했습니다. 결재 서류가 앞 사람 도장을 받아야만 다음 사람에게 넘어가는 것과 같습니다. GPU(원래 그래픽 처리용으로 만들어, 단순한 계산 수천 개를 한꺼번에 해내는 칩)가 아무리 많아도, 이런 순차 의존성 때문에 속도를 내기 힘들었습니다. 둘째, 문장이 길어지면 앞부분 정보가 뒤로 갈수록 흐려졌습니다. 문장 전체를 하나의 고정된 벡터(뜻을 숫자 목록으로 적은 좌표)에 욱여넣다 보니, 긴 문장의 초반 내용이 병목에 걸려 사라지곤 했습니다.
이 병목을 누그러뜨리려는 시도가 어텐션(attention)이었습니다. 「Neural Machine Translation by Jointly Learning to Align and Translate」는 번역할 때 출력 단어마다 입력 문장의 어느 부분을 볼지 그때그때 가중치를 두어 참조하게 했습니다. 문장 전체를 한 벡터로 압축하지 않고, 필요할 때마다 원문의 관련 부분을 직접 들여다본 것입니다. 성능이 눈에 띄게 올라갔습니다.
그러자 자연스러운 질문이 나왔습니다. 순환 구조를 보조하는 장치가 어텐션이라면, 아예 순환을 걷어내고 어텐션만으로 문장을 처리하면 어떨까요? 「Attention Is All You Need」라는 도발적인 제목이 그 답이었습니다. 순서 의존성을 없애자 문장의 모든 위치를 동시에 계산할 수 있게 됐고, GPU 병렬 처리의 이점을 온전히 끌어냈습니다. 트랜스포머가 대규모 학습의 시대를 연 결정적 계기입니다.
문장을 숫자 좌표로: 토큰화와 임베딩
트랜스포머에 문장이 들어가기 전에 두 단계의 준비가 필요합니다. 컴퓨터는 글자를 그대로 읽지 못하고 숫자만 다루기 때문입니다. 첫 단계는 토큰화(tokenization)입니다. 문장을 토큰이라는 조각으로 자릅니다. 토큰은 단어일 수도, 단어의 일부일 수도, 글자 하나일 수도 있습니다. 예를 들어 'cyberpunk' 같은 드문 단어는 'cyber'와 'punk'로 쪼개 조립합니다. 자주 뭉쳐 다니는 덩어리는 통째로, 드문 것은 잘게 자르는 절충인데, 이렇게 하면 정해진 수의 조각만으로 세상의 온갖 단어를 표현할 수 있습니다.
여기서 언어별 차이가 생깁니다. 영어는 대체로 토큰 하나가 네 글자쯤에 대응하고, 한국어는 같은 뜻을 담아도 조각이 더 잘게 납니다. 그래서 같은 분량의 글이라도 한국어가 토큰 한도에 더 빨리 닿고, 사용량만큼 과금하는 서비스에서는 더 비싸게 계산되기도 합니다. OpenAI의 토크나이저 도구에 문장을 넣어 보면 조각과 그 개수가 색으로 표시되는데, '문장이 숫자 조각으로 바뀐다'는 개념이 이 짧은 실험으로 구체적인 사실이 됩니다.
토큰에는 저마다 고유 번호가 붙습니다. 그런데 번호는 이름표에 지나지 않습니다. '고양이'가 5번, '강아지'가 8721번이라 해도, 두 번호만 봐서는 이들이 얼마나 비슷한 뜻인지 알 길이 없습니다. 그래서 두 번째 단계로 임베딩(embedding)이 등장합니다. 토큰 하나를 숫자 하나가 아니라 숫자 여러 개의 묶음, 곧 좌표로 바꿉니다. 이 좌표 공간을 '의미의 지도'라고 부를 만합니다. 뜻이 가까운 토큰은 지도 위에서 가깝게, 먼 토큰은 멀리 놓입니다.
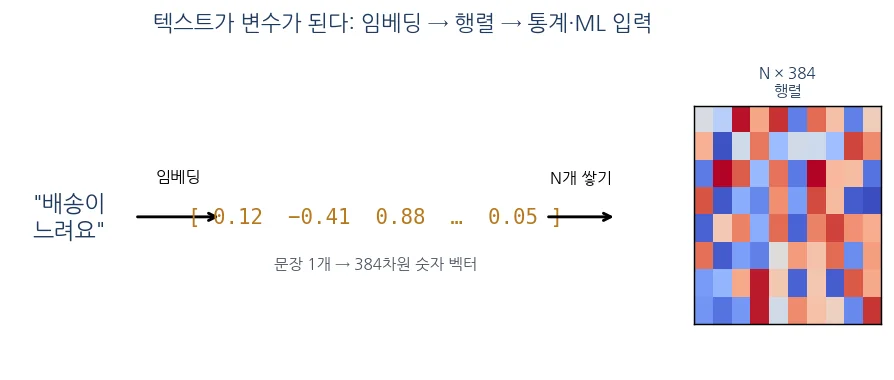
임베딩 벡터는 학습을 거쳐 자리를 잡습니다. 방대한 글을 읽으며 비슷한 문맥에 자주 등장하는 토큰끼리 좌표가 가까워지도록 조정됩니다.
여기에 위치 인코딩(positional encoding)으로 위치 정보를 더합니다. 트랜스포머는 문장을 한꺼번에 받아들이기 때문에, 그대로 두면 단어들을 순서 없는 카드 묶음처럼 봅니다. 카드를 섞어도 같은 묶음이듯, 순서만 다른 두 문장을 구별하지 못합니다. 영어로 예를 들면 "dog bites man"(개가 사람을 물었다)과 "man bites dog"(사람이 개를 물었다)는 똑같은 세 단어로 이뤄져 있고 순서만 다릅니다. 영어에서는 순서가 곧 '누가 누구를'입니다. 한국어는 '가'와 '를' 같은 조사가 역할을 알려 주어 이 예가 그대로 들어맞지는 않지만, 모델 입장에서는 어느 언어든 조각의 순서를 알아야 뜻을 제대로 잡습니다. 순환 신경망은 토큰을 순서대로 하나씩 읽으면서 순서를 자연히 알았지만, 트랜스포머는 한꺼번에 읽는 대가로 순서 감각을 잃었습니다. 그래서 각 토큰이 문장에서 몇 번째인지를 좌표에 얹어 줍니다. 순서를 잃지 않으면서 병렬 처리의 이점을 챙기는 장치입니다. 위치를 적어 넣는 구체적인 방식은 글 끝 심화 절에서 다룹니다.
자기어텐션: 단어들이 서로 주목하는 법
트랜스포머의 핵심은 자기어텐션(self-attention)입니다. 문장 속 각 토큰이 다른 모든 토큰을 둘러보며 '누구에게 얼마나 주목할지'를 스스로 계산합니다. 회의 장면에 빗대면 쉽습니다. 회의 중에 누군가 "그 건은 다음 주로 미루죠"라고 말하면, 우리는 앞선 발언들을 떠올려 '그 건'이 무엇인지 찾습니다. 모든 발언을 똑같이 떠올리지 않고, 관련 있어 보이는 발언에 더 무게를 둡니다. 자기어텐션이 하는 일이 바로 이것입니다.
한국어의 동음이의어로 보면 더 분명합니다. '배를 타고 강을 건너다 배가 고파 배를 깎아 먹었다'라는 문장에는 '배'가 세 번 나옵니다. 첫째 '배'가 탈것이라는 걸 알려면 '타고'에, 둘째 '배'가 몸의 배라는 걸 알려면 '고파'에, 셋째 '배'가 과일이라는 걸 알려면 '깎아'와 '먹었다'에 강하게 주목해야 합니다. 글자는 똑같아도 어느 단어를 참고하느냐에 따라 뜻이 갈립니다. 자기어텐션은 바로 이 주목의 세기를 수치로 뽑습니다.
작동 방식을 직관적으로 풀면 이렇습니다. 각 토큰은 세 가지 역할의 벡터를 만듭니다. 질의(Query)는 '나는 무엇을 찾고 있는가', 키(Key)는 '나는 어떤 정보를 갖고 있는가', 값(Value)은 '내가 실제로 전달할 내용'입니다. 회의에 다시 빗대면 질의는 '그 건이 뭐였지?'라는 내 궁금증, 키는 앞선 발언마다 붙은 주제 꼬리표, 값은 그 발언의 실제 내용입니다. 한 토큰의 질의를 다른 모든 토큰의 키와 맞춰 보고, 잘 맞을수록 높은 점수를 줍니다. 이 점수를 모두 더해 1이 되는 비율로 바꿔 가중치로 삼은 뒤, 각 토큰의 값을 그 가중치로 섞습니다. 그 결과 각 토큰은 자기와 관련 깊은 토큰들의 정보를 끌어모은 새 표현으로 갱신됩니다.
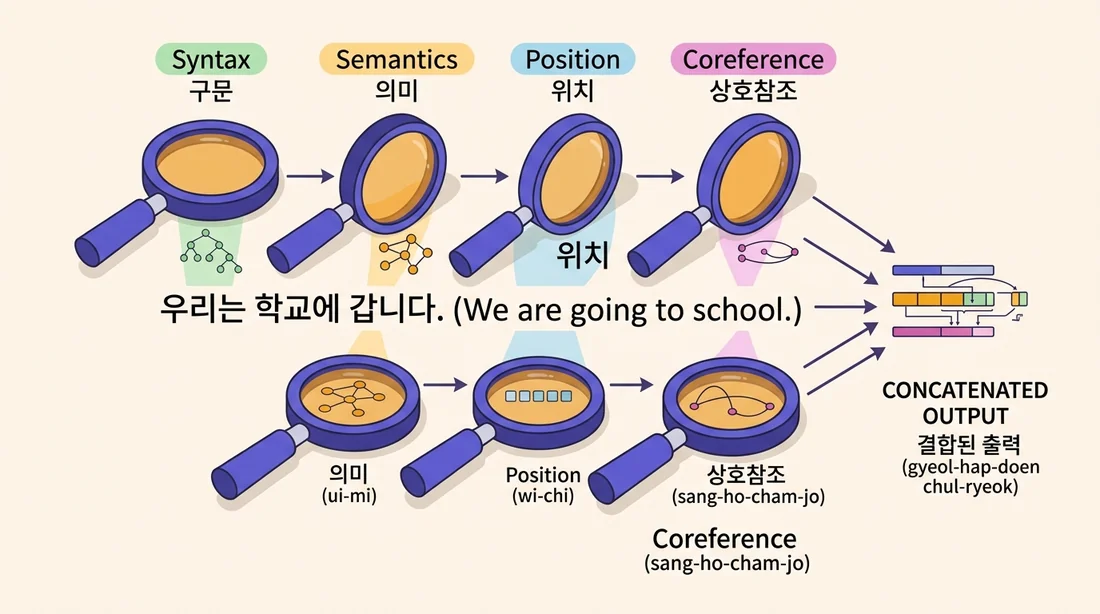
여기서 '멀티헤드(multi-head)'라는 개념이 붙습니다. 주목을 한 방향으로만 하면 놓치는 관계가 생깁니다. 문장 하나에도 문법적 의존 관계, 의미의 유사성, 대명사가 가리키는 대상 같은 서로 다른 종류의 관계가 겹겹이 있는데, 어텐션 하나가 이 모두를 한꺼번에 담기는 벅찹니다. 그래서 여러 개의 어텐션 헤드(head, 어텐션을 계산하는 '머리' 하나)를 나란히 두고, 각 헤드가 서로 다른 관점에서 관계를 살피게 합니다. 같은 회의록을 재무 담당은 숫자 위주로, 법무 담당은 계약 조항 위주로, 팀장은 일정 위주로 읽는 것과 비슷합니다. 여러 헤드의 결과를 합치면 문맥을 훨씬 풍부하게 담아냅니다.
실제 학습된 모델을 뜯어보면 어떤 헤드는 바로 앞 단어에만 주목하고, 어떤 헤드는 문장 끝의 마침표를 추적하며, 또 어떤 헤드는 특정 구문 구조에 반응합니다. 물론 모든 헤드가 뚜렷한 역할을 맡지는 않습니다. 상당수 헤드는 제거해도 성능이 거의 떨어지지 않는다는 연구 결과가 있는데, 모델에 여분이 많다는 뜻입니다.
이 구조의 강점은 거리에 구애받지 않는다는 점입니다. 순환 신경망에서는 멀리 떨어진 두 단어를 연결하려면 그 사이 모든 단계를 거쳐야 했습니다. 트랜스포머에서는 문장 첫 토큰과 마지막 토큰이 한 번의 어텐션 계산으로 직접 연결됩니다. 긴 문장에서 앞뒤 맥락을 잇는 능력이 여기서 나옵니다. 대신 모든 토큰 쌍을 계산해야 한다는 대가가 따르는데, 이 비용은 뒤의 '제곱으로 불어나는 계산량' 절에서 따로 다룹니다.
인코더와 디코더: 두 갈래로 갈린 계보
원래 트랜스포머는 번역을 위해 인코더(encoder)와 디코더(decoder) 두 부분으로 설계됐습니다. 인코더는 원문을 읽고 이해하는 쪽, 디코더는 그 이해를 바탕으로 글을 써 내는 쪽입니다. 인코더는 입력 문장 전체를 앞뒤 양방향으로 훑어 문맥이 배어든 표현을 만듭니다. 디코더는 그 표현을 참조하면서 출력 문장을 한 토큰씩 생성합니다. 이때 디코더는 아직 생성하지 않은 미래의 토큰을 미리 보지 못하도록 가려 둡니다. 시험 문제를 풀 때 뒤쪽 정답지를 종이로 덮어 두는 것과 같습니다. 이 '마스킹(가리기)'이 앞에서부터 한 토큰씩 이어 쓰는 생성 방식의 핵심 장치입니다.
이후 연구는 두 부분을 따로 떼어 쓰는 방향으로 갈라졌습니다. 인코더만 쓰는 계열의 대표가 BERT입니다. 「BERT: Pre-training of Deep Bidirectional Transformers」는 문장을 양방향으로 읽어 문맥을 깊이 이해하는 데 강합니다. 문장 분류, 개체명 인식(문장에서 사람 이름, 회사명, 지명 같은 고유한 이름을 찾아 표시하는 작업), 질문의 답 찾기처럼 '이해'가 중요한 작업에 잘 맞습니다. 문장 중간의 일부 토큰을 가린 뒤 맞추게 하는 방식으로 학습합니다. 검색과 RAG(답하기 전에 관련 문서를 먼저 찾아 붙여 주는 방식)의 핵심인 임베딩 생성에도 인코더 계열이 널리 쓰입니다.
디코더만 쓰는 계열의 대표가 GPT입니다. 왼쪽에서 오른쪽으로만 읽으며 다음 토큰을 예측하도록 학습합니다. 문장을 이어 쓰고 대화를 생성하는 데 특화됐고, 오늘날 우리가 쓰는 대화형 LLM 대부분이 이 계열입니다. 인코더와 디코더를 모두 쓰는 계열(T5 등)은 번역이나 요약처럼 입력을 받아 다른 형태의 출력을 내놓는 작업에 쓰입니다.
절반을 버린 디코더가 왜 주류가 됐을까요? 순수 디코더 모델은 오직 한 가지 목표로 학습합니다. 앞 토큰들을 보고 다음 토큰을 맞히는 것입니다. 이 단순한 목표가 강력한 이유는 세상의 거의 모든 텍스트가 그대로 학습 데이터가 되기 때문입니다. 정답 라벨을 사람이 붙일 필요 없이, 인터넷의 방대한 텍스트를 순서대로 흘려보내기만 하면 됩니다. 규모를 키우기가 훨씬 쉽고, 모델 크기와 데이터, 계산량을 늘리면 성능이 예측 가능한 곡선을 따라 매끄럽게 오른다는 관찰(스케일링 법칙, scaling law)이 나오면서 업계는 이 노선에 자원을 쏟아부었습니다. 아래 표에 세 계보를 정리했습니다.
| 구조 | 대표 모델 | 강점 작업 | 학습 방식 |
|---|---|---|---|
| 순수 인코더 | BERT 계열 | 분류·임베딩·이해 | 가린 단어 맞히기 |
| 순수 디코더 | GPT·LLaMA 계열 | 생성·대화·추론 | 다음 토큰 예측 |
| 인코더-디코더 | T5 계열 | 번역·요약 | 입력 문장을 다른 문장으로 바꾸기 |
결국 어떤 구조가 절대적으로 우월하다기보다, 풀려는 문제의 성격이 선택을 좌우합니다. 생성과 범용성을 원하면 디코더, 문서를 벡터로 바꿔 검색하려면 인코더가 자연스러운 출발점입니다. 다만 최근에는 디코더 모델의 규모와 일반화 능력이 워낙 압도적이라, 예전에 인코더가 맡던 이해 작업까지 디코더 모델이 프롬프트만으로 처리하는 경우가 늘고 있습니다.
트랜스포머는 이런 어텐션 블록을 한 층으로 끝내지 않고 수십 층 쌓습니다. 층이 깊어져도 학습이 무너지지 않도록 받쳐 주는 장치(잔차 연결과 정규화)가 있는데, 직접 모델을 만지는 개발자에게 필요한 내용이라 글 끝 심화 절로 옮겼습니다.
다음 토큰을 고르는 순간: 확률 분포와 디코딩
트랜스포머의 마지막 층을 지나면 각 위치마다 다음에 올 토큰의 점수가 나옵니다. 이 점수를 소프트맥스(softmax), 곧 점수들을 모두 더해 1이 되는 확률로 바꿔 주는 계산에 넣으면 어휘 전체에 걸친 확률 분포가 됩니다. 예를 들어 '오늘 날씨가 참' 다음에 '좋다'가 0.62, '맑다'가 0.15, '춥다'가 0.08 하는 식으로 후보마다 확률이 매겨집니다. 언어 모델의 생성은 이 분포에서 토큰을 하나 골라 문장 끝에 붙이고, 늘어난 문장을 다시 입력으로 넣어 다음 토큰을 고르는 반복입니다. 자기가 낸 출력을 다시 입력으로 삼는 이 되먹임을 자기회귀(autoregressive)라 부릅니다.
'어떻게 고를 것인가'를 조절하는 손잡이가 디코딩 파라미터입니다. 온도(temperature)를 낮추면 확률 높은 후보에 쏠려 보수적이고 일관된 문장이, 높이면 다양하지만 엉뚱할 수 있는 문장이 나옵니다. top-k, top-p 같은 다른 손잡이와 실제 쓰임새는 프롬프트 엔지니어링 글에서 자세히 다룹니다.
정리하면 트랜스포머의 생성은 '토큰화 → 임베딩 → 어텐션 → 확률 분포 → 선택'이 하나의 루프로 맞물려 돌아가는 과정입니다. 유창해 보이는 대답도 실은 이 다섯 동작을 토큰 하나를 만들 때마다 되풀이한 결과입니다(이미 처리한 앞 토큰은 다시 자르고 바꾸지 않습니다).
제곱으로 불어나는 계산량: 긴 문맥의 진짜 비용
모든 토큰이 서로를 본다는 강점이 곧 비용입니다. 회의 참석자 10명이 저마다 모든 참석자(자기 포함)의 발언을 한 번씩 되짚으면 100번을 확인해야 하고, 20명이면 400번으로 뛰는 것과 같습니다. 토큰이 n개면 n×n 번의 계산이 필요하다는 뜻입니다. 문맥 길이가 두 배가 되면 연산량은 네 배로 뜁니다. 어텐션 표를 통째로 만드는 표준 구현에서는 메모리도 네 배가 듭니다. 이 제곱 비용이 긴 문맥을 다루는 트랜스포머의 근본 병목입니다. 문서 요약, 긴 계약서 검토, 긴 대화 기억처럼 문맥이 길수록 좋은 작업에서 이 비용은 곧바로 요금과 응답 시간으로 이어집니다. 긴 문맥을 다루려는 여러 개선 기법이 나왔지만(심화 절 참고) 근본적인 부담은 남아 있습니다.
이 비용 구조를 이해하면 실무 판단이 분명해집니다. 문맥에 자료를 무작정 다 밀어 넣는 대신, RAG로 정말 필요한 조각만 추려 넣는 편이 비용과 정확도 양쪽에서 유리할 때가 많습니다. 컨텍스트 창(context window, 모델이 한 번에 읽을 수 있는 글의 최대 길이)이 아무리 넓어져도 제곱 비용은 사라지지 않고, 게다가 긴 문맥의 중간에 놓인 정보를 모델이 놓치는 현상도 보고됩니다. 컨텍스트 창의 크기와 실제로 잘 활용되는 정보량은 별개라는 점을 늘 염두에 두어야 합니다.
실무에서 트랜스포머를 마주하는 자리
트랜스포머를 직접 만들 일은 거의 없습니다. 대부분은 ChatGPT 같은 서비스로 만나고, 개발자도 이미 학습된 모델을 불러와 씁니다. 그래도 앞서 다룬 개념들은 그대로 실무 감각으로 이어집니다. 토큰 수를 가늠할 줄 알면 길이 제한과 비용을 미리 짐작할 수 있고, 온도 같은 설정을 이해하면 원하는 문체와 안정성을 얻기 쉽습니다.
파인튜닝(fine-tuning)은 이미 학습된 트랜스포머에 특정 분야의 글을 더 읽혀 그 작업에 맞게 다듬는 추가 학습입니다. 법률 문서에 강한 모델, 의료 상담에 특화된 모델을 만들 때 씁니다. 다만 모델 전체를 다시 학습하려면 비용이 크기 때문에, 최근에는 원래 숫자는 그대로 두고 작은 부품을 덧붙여 그것만 학습하는 가벼운 방법이 널리 쓰입니다.
검색 증강 생성(RAG, Retrieval-Augmented Generation)은 트랜스포머 모델의 약점을 보완하는 대표적 방법입니다. 모델은 학습 시점 이후의 정보나 회사 내부 문서를 알지 못합니다. RAG는 질문이 들어오면 관련 문서를 먼저 검색해 그 내용을 프롬프트에 함께 넣어 줍니다. 이때 문서를 임베딩 벡터로 바꿔 의미가 가까운 것을 찾는데, 바로 트랜스포머가 만든 그 임베딩 공간을 활용하는 것입니다. 모델을 다시 학습하지 않고도 최신 지식이나 사내 자료를 반영할 수 있어 실무에서 자주 씁니다.
자주 걸려 넘어지는 오해와 구조적 한계
가장 흔한 오해는 '트랜스포머가 문장의 뜻을 사람처럼 이해한다'는 생각입니다. 실제로 모델이 하는 일은 방대한 글에서 배운 통계적 패턴을 바탕으로 다음 토큰의 확률을 계산하는 것뿐입니다. 그럴듯한 문장을 만드는 능력과 사실을 아는 능력은 다릅니다. 그래서 존재하지 않는 사실을 자신 있게 지어내는 환각(hallucination)이 생깁니다. 확률적으로 가장 그럴듯한 이어짐이 반드시 참은 아니기 때문입니다.
구조적 한계도 뚜렷합니다. 앞서 본 제곱 비용 때문에 처리할 수 있는 문맥 길이에 한계가 있고, 길게 넣을수록 비싸고 느려집니다. 또 하나, 트랜스포머는 학습한 데이터에 담긴 편향을 그대로 물려받습니다. 데이터에 특정 관점이나 차별이 배어 있으면 출력도 그 경향을 띱니다. 모델의 판단이 중립적이거나 객관적이라고 믿는 것은 위험합니다. 실무에서는 출력을 검증하고 걸러 내는 안전장치를 함께 두어야 합니다.
마지막으로 토큰화 자체의 한계도 있습니다. 한국어처럼 조각이 잘게 나는 언어는 같은 뜻을 더 많은 토큰으로 표현하고, 드문 단어나 오타는 예상치 못한 방식으로 쪼개집니다. 이것이 길이 제한, 비용, 때로는 모델의 이해도에까지 영향을 미칩니다.
더 깊이 파고들려면: 이어지는 개념들
원전을 직접 읽는 것이 가장 확실합니다. 「Attention Is All You Need」는 트랜스포머의 출발점이고, 이해하기 어렵다면 그림으로 풀어낸 「The Illustrated Transformer」나 코드와 함께 한 줄씩 짚어 주는 「The Annotated Transformer」를 곁들이면 좋습니다. 인코더 계열과 양방향 학습이 궁금하면 BERT 논문을, 트랜스포머 이전의 흐름과 어텐션의 기원을 알고 싶다면 시퀀스 투 시퀀스 논문과, 번역할 단어마다 원문의 어느 부분을 볼지 정렬하게 한 바다나우 등의 어텐션 논문(2014)을 함께 보면 맥락이 잡힙니다.
개념의 연결 고리도 챙겨 두면 좋습니다. 토큰화와 임베딩은 벡터 검색과 RAG로, 자기어텐션은 멀티헤드와 위치 인코딩으로, 확률 분포와 디코딩은 온도 같은 실전 파라미터와 프롬프트 엔지니어링으로 뻗어 나갑니다. 여기에 파인튜닝, 경량 학습 기법을 얹으면 트랜스포머 기반 LLM을 실무에서 다루는 그림이 완성됩니다.
무엇보다 오늘날 대화형 LLM의 뼈대인 디코더 계열 트랜스포머를 '다음 단어 예측기'라는 한마디로 붙잡아 두면 좋습니다. 화려한 대화도, 긴 문서 요약도, 코드 생성도 결국 토큰을 하나씩 골라 붙이는 반복입니다. 이 뼈대를 잡고 나면 새로 등장하는 모델이나 기법도 '이 다섯 동작 중 어디를 어떻게 개선했나'라는 눈으로 읽어낼 수 있습니다.
개발자를 위한 심화
이 부분은 직접 구현하는 개발자를 위한 내용입니다.
사전학습 모델을 불러와 쓰기
대부분의 개발자는 트랜스포머를 밑바닥부터 구현하지 않습니다. 이미 학습된 모델을 불러와 쓰는 것이 일반적입니다. 예컨대 Hugging Face의 transformers 라이브러리를 쓰면 몇 줄로 사전학습 모델을 불러와 문장을 요약하거나 감정을 분류할 수 있습니다. 본문에서 말한 가벼운 파인튜닝은 LoRA처럼 원래 가중치는 얼려 두고 작은 행렬 몇 개만 더해 학습하는 방식이 대표적입니다.
위치 인코딩의 속사정
원논문이 제안한 방식은 사인·코사인 함수를 쓰는 고정 인코딩입니다. 위치 pos와 차원 인덱스 i, 모델 차원 d에 대해 짝수 차원에는 sin(pos/10000^(2i/d)), 홀수 차원에는 cos(...)를 채웁니다. 주기가 서로 다른 파동을 여러 개 겹쳐 각 위치마다 고유한 벡터 지문을 만드는 셈입니다. 이 방식의 묘미는 상대 위치를 선형 변환으로 표현할 수 있다는 데 있습니다. pos+k 위치의 인코딩은 pos 위치 인코딩의 회전으로 얻어지므로, 모델이 "세 칸 뒤" 같은 상대적 거리를 학습하기 수월합니다. 학습 없이 계산으로 구하므로 훈련 때 본 적 없는 긴 문장에도 그럭저럭 대응합니다.
최근 대규모 언어 모델은 고정 인코딩 대신 회전 위치 임베딩(RoPE, Rotary Position Embedding)을 널리 씁니다. RoPE는 위치 정보를 벡터에 더하지 않고, 쿼리와 키 벡터를 위치에 비례한 각도만큼 회전시킵니다. 시곗바늘을 위치만큼 돌려 두면 두 바늘 사이의 각도로 거리를 알 수 있는 것과 같은 발상입니다. 두 토큰의 어텐션 점수가 자연스럽게 상대 거리에만 의존하게 되어, 긴 문맥 확장에 유리합니다. 실제로 LLaMA 계열을 비롯한 다수의 오픈 모델이 RoPE를 채택했고, 회전 각도의 기저를 조정해 문맥 길이를 나중에 늘리는 기법도 활발히 연구됩니다.
실무에서 위치 인코딩은 평소엔 존재를 잊고 지내다가 문맥 길이를 늘릴 때 갑자기 발목을 잡습니다. 훈련 때 본 길이보다 훨씬 긴 입력을 밀어 넣으면, 훈련 분포를 벗어난 위치 신호가 들어와 성능이 급격히 무너집니다. 이 문제를 다루는 실전 기법이 위치 보간(position interpolation, 긴 위치 번호를 훈련 때 본 범위 안으로 촘촘히 눌러 담는 방법)이나 NTK 스케일링(RoPE의 회전 기저를 키워 빠르게 도는 성분은 살리고 느리게 도는 성분만 늘리는 방법)입니다. 컨텍스트 창을 확장한 모델을 고를 때 어떤 위치 인코딩을 쓰는지, 어떤 방식으로 확장했는지 확인하는 습관이 성능 예측에 큰 도움이 됩니다.
멀티헤드의 차원 분할과 KV 캐시
구체적으로는 모델 차원 d를 헤드 수 h로 나눠 각 헤드가 d/h 차원에서 독립적으로 쿼리·키·값을 만듭니다. 예를 들어 d가 512이고 헤드가 8개면 헤드마다 64차원에서 어텐션을 계산한 뒤 결과를 이어 붙이고 다시 선형 변환합니다.
추론 속도가 중요한 실무에서는 헤드 구조가 곧 비용입니다. 생성은 토큰을 하나씩 붙여 가므로, 앞 토큰들의 키와 값을 매번 다시 계산하지 않도록 메모리에 보관해 둡니다. 이 보관소가 키·값 캐시(KV cache)입니다. 표준 멀티헤드 어텐션은 헤드마다 키와 값을 따로 저장하므로, 긴 문맥을 생성할 때 이 캐시가 메모리를 많이 차지합니다. 이를 줄이려고 여러 쿼리 헤드가 키·값을 공유하는 그룹 쿼리 어텐션(GQA, Grouped-Query Attention)이나, 극단적으로 하나만 공유하는 멀티쿼리 어텐션(MQA, Multi-Query Attention)이 등장했습니다. 아래 표는 세 방식의 차이를 정리한 것입니다.
| 방식 | 키·값 헤드 | 장점 | 대가 |
|---|---|---|---|
| 멀티헤드(MHA) | 쿼리 헤드마다 각각 | 표현력 최대 | KV 캐시 큼, 느림 |
| 그룹 쿼리(GQA) | 그룹당 하나 공유 | 균형점 | 약간의 품질 손실 |
| 멀티쿼리(MQA) | 전체가 하나 공유 | 캐시 최소, 빠름 | 품질 저하 위험 |
최신 오픈 모델 다수가 GQA를 기본값으로 택한 이유가 여기 있습니다. 품질을 크게 해치지 않으면서 생성 속도와 메모리를 함께 잡기 때문입니다. 트랜스포머를 서빙할 때 배치 크기와 문맥 길이가 늘어날수록 병목은 연산량보다 KV 캐시 메모리로 옮겨 갑니다. 어떤 어텐션 변형을 쓰는지가 서빙 비용을 좌우한다는 점을 기억해 둘 만합니다.
층을 깊게 쌓아도 무너지지 않는 이유: 잔차 연결과 정규화
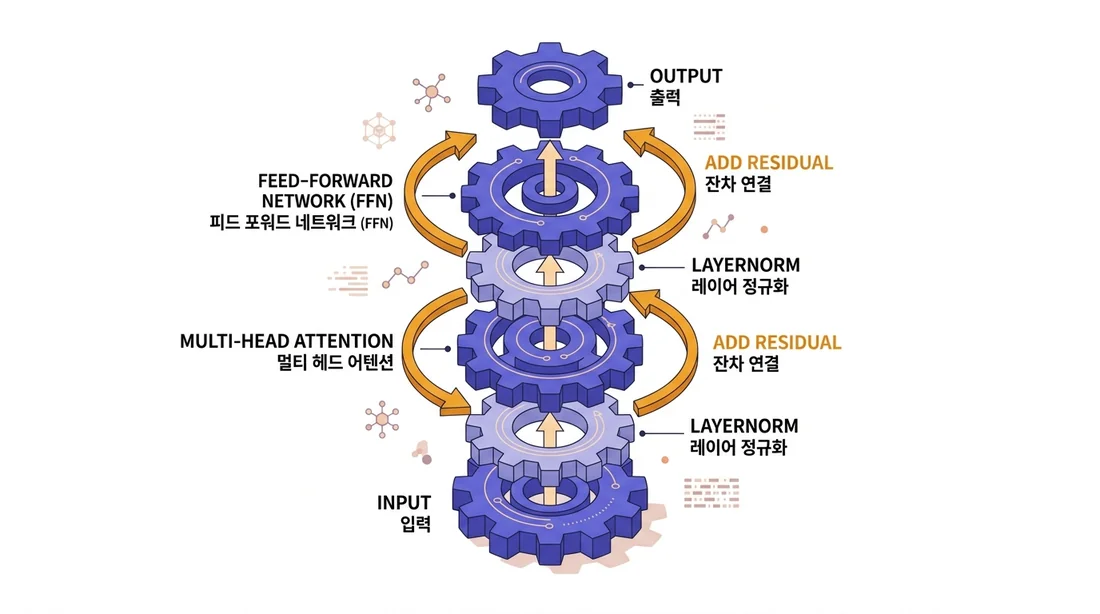
트랜스포머의 한 층은 어텐션과 피드포워드망(FFN, 어텐션을 거친 토큰 하나하나를 따로 한 번 더 가공하는 작은 신경망)으로 이뤄지고, 본문에서 말했듯 이 층을 수십 개 쌓습니다. GPT 계열 대형 모델은 수십에서 백 단위의 층을 쌓기도 합니다. 신경망을 깊게 쌓으면 기울기(학습 때 각 숫자를 어느 쪽으로 얼마나 고칠지 알려 주는 신호)가 소실되거나 폭발해 학습이 안 되는 게 상식인데, 트랜스포머는 어떻게 이 깊이를 견딜까요? 핵심 장치가 잔차 연결(residual connection)과 층 정규화(layer normalization)입니다. 둘은 화려하지 않지만, 이것이 빠지면 깊은 트랜스포머는 학습 자체가 되지 않습니다.
잔차 연결은 각 서브층의 출력에 입력을 그대로 더해 줍니다. 수식으로는 출력이 x + f(x)가 됩니다. 이렇게 하면 역전파(출력의 오차를 거꾸로 흘려보내며 각 층의 숫자를 고치는 학습 절차) 때 기울기가 f를 거치지 않고도 항등 경로를 따라 곧장 아래층으로 흐릅니다. 층이 깊어져도 기울기가 지수적으로 줄지 않는 고속도로가 생기는 것과 같습니다. 덕분에 각 층은 입력을 통째로 다시 만들 필요 없이, 필요한 만큼의 보정치만 학습하면 됩니다. 학습 부담이 크게 줄어듭니다.
층 정규화는 각 토큰 벡터의 값을 평균 0, 분산 1 부근으로 다듬어 층을 거치며 값의 크기가 제멋대로 커지거나 작아지는 것을 막습니다. 초기 트랜스포머는 서브층 뒤에 정규화를 두는 사후 정규화(post-LN)를 썼지만, 이 방식은 아주 깊은 모델에서 학습이 불안정했습니다. 그래서 요즘 대형 모델은 서브층 앞에 정규화를 두는 사전 정규화(pre-LN)를 표준으로 삼습니다. 사전 정규화는 학습 초기 안정성이 훨씬 좋아 워밍업(학습 초반에 학습률을 작게 시작해 서서히 올리는 절차) 없이도 학습이 된다는 연구가 있습니다. 여기에 평균을 빼는 단계를 생략하고 값의 크기만 맞춰 계산이 가벼운 RMSNorm으로 갈아탄 모델도 많습니다.
이 부분은 대개 프레임워크가 알아서 처리하므로 직접 만질 일이 드뭅니다. 다만 모델을 직접 파인튜닝하거나 구조를 손볼 때 학습 손실이 초반부터 발산한다면, 정규화 위치와 학습률 워밍업을 먼저 의심하는 것이 정석입니다. 잔차 연결과 정규화는 모델 성능표에 이름을 올리는 화려한 요소는 아니지만, 오늘날의 초거대 모델을 물리적으로 가능하게 만든 조용한 토대입니다.
제곱 비용을 줄이려는 시도: 플래시어텐션과 희소 어텐션
토큰이 n개면 어텐션 행렬은 n×n 크기가 됩니다. 이 문제를 정면으로 공략한 대표적 성과가 플래시어텐션(FlashAttention)입니다. 거대한 n×n 어텐션 행렬을 통째로 메모리에 올리지 않고, 작은 블록으로 쪼개 GPU의 빠른 온칩 메모리 안에서 계산하고 버립니다. 수학적 결과는 표준 어텐션과 완전히 같지만, 느린 메모리를 오가는 횟수를 크게 줄여 실제 속도를 끌어올립니다. 정확도를 전혀 잃지 않고 구현 방식만으로 속도를 얻은 사례라 의미가 큽니다.
다른 갈래는 어텐션의 범위를 아예 줄이는 접근입니다. 모든 토큰을 다 보지 않고 가까운 이웃 몇 개와 소수의 전역 토큰만 보게 하는 희소 어텐션(sparse attention), 어텐션을 저차원으로 근사하는 선형 어텐션 계열이 여기 속합니다. 이론상 복잡도를 선형에 가깝게 낮추지만, 실제로는 품질 손실이나 하드웨어 효율 문제로 표준 어텐션을 완전히 밀어내지는 못했습니다. 현장에서는 정확한 계산을 유지한 플래시어텐션이 더 널리 쓰입니다.